在上篇《开源 TauGrid:Kubernetes 上的云原生 GPU 基础设施》中,我介绍了 TauGrid 的由来,包括 TauGrid 是什么、怎么安装使用以及怎么跑第一个任务等。那篇文章的主要内容是快速上手,很多设计上的取舍没有展开。
今天的文章就来补上这块的缺口,进一步介绍 TauGrid 的架构设计和工作原理。这也是我上周在 KubeCon China 2026 上分享的《From Data Preparation to Inference: Closing the Lifecycle Gap in AI Infrastructure on Kubernetes》文字稿。
问题到底出在哪
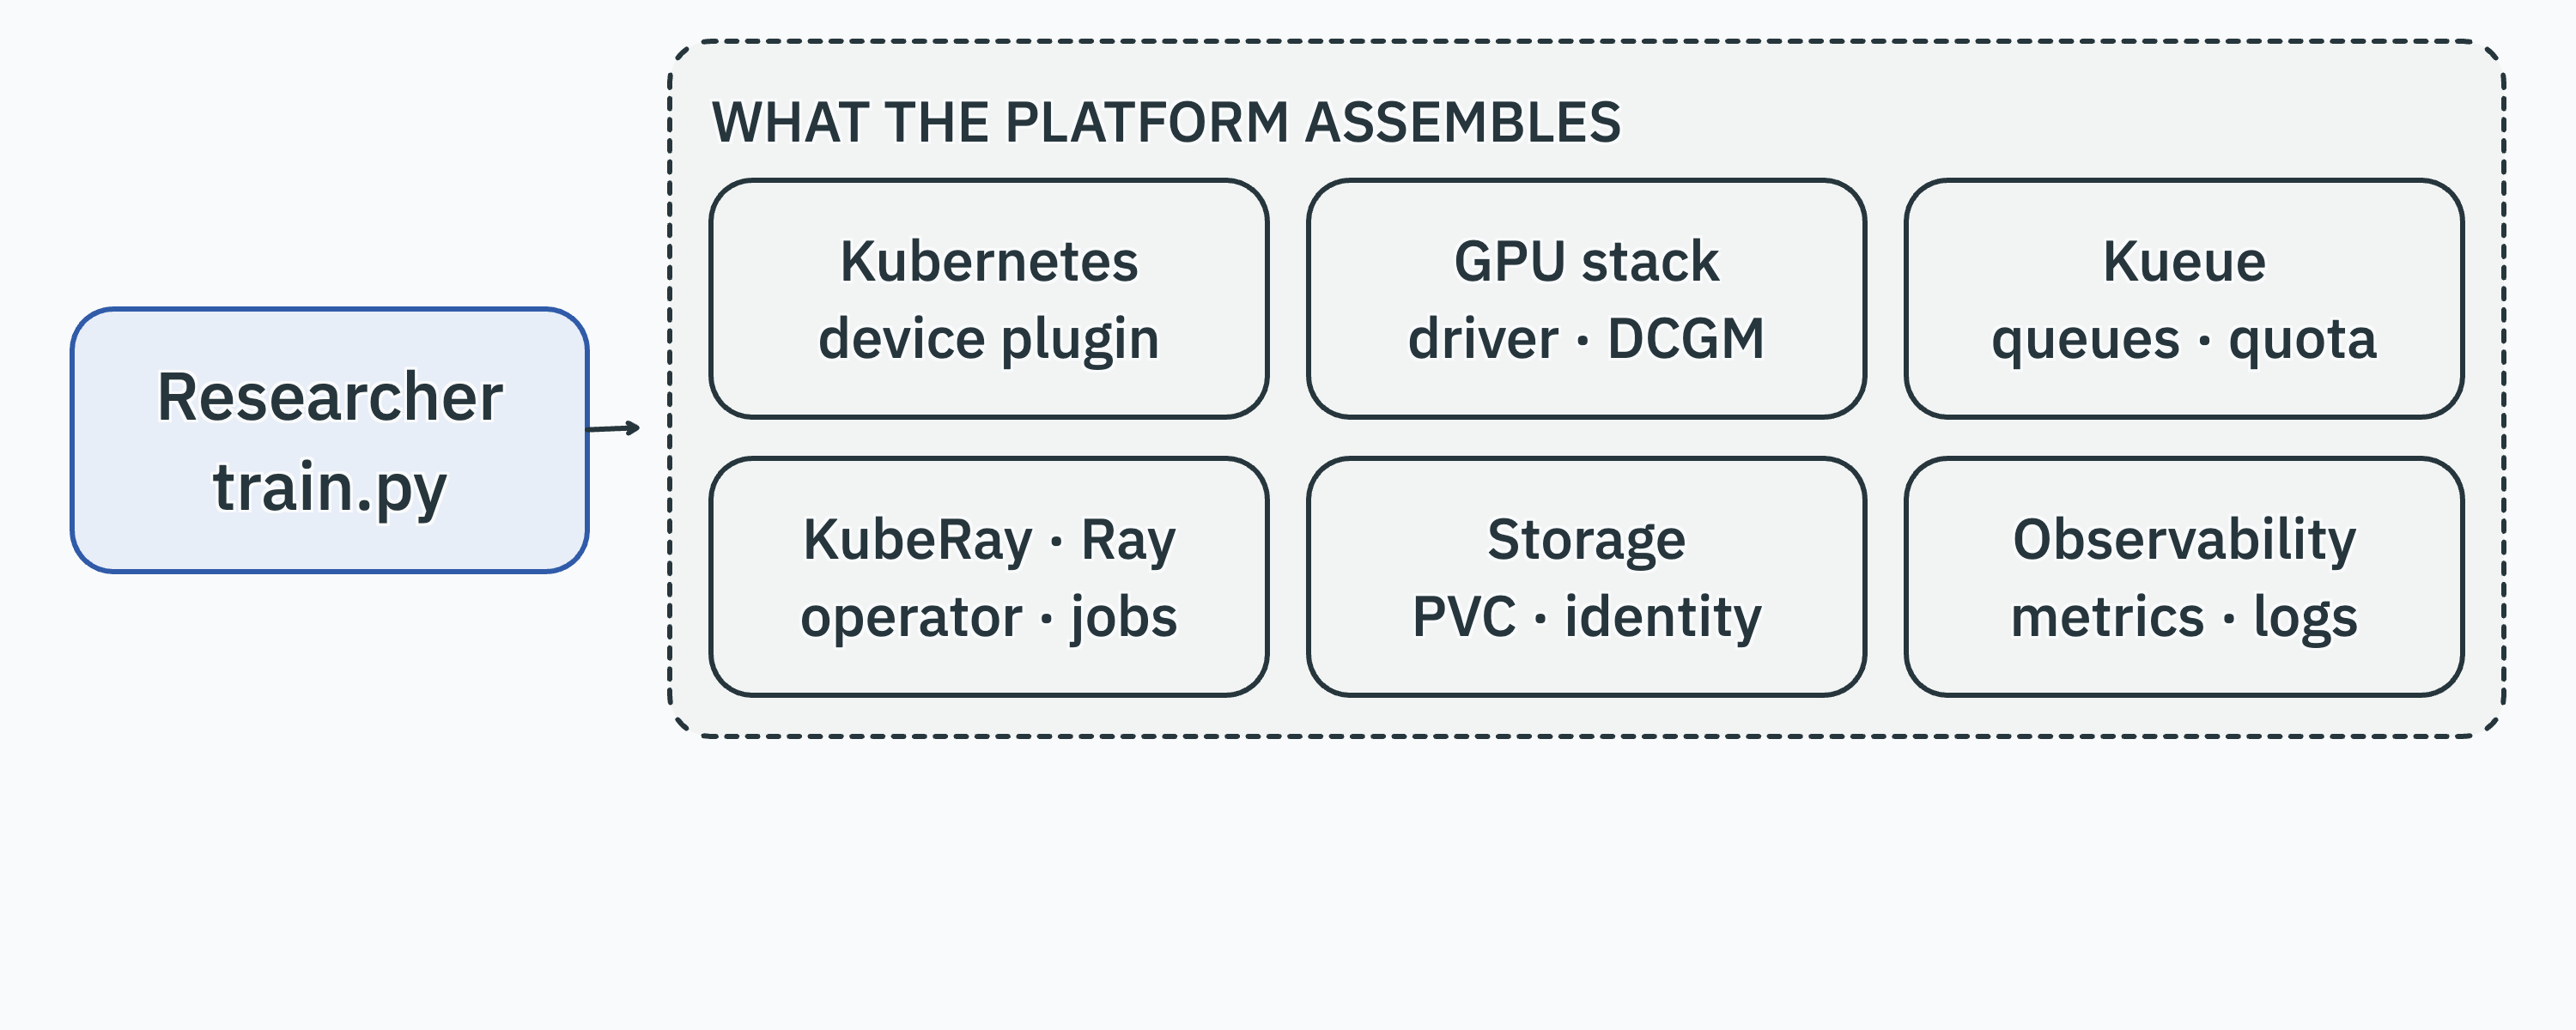
在上篇中我提到,Kubernetes 生态非常繁荣,有各种针对 AI 训练任务的开源项目,拿过来安装就可以直接使用。比如说,通常 AI 训练任务需要安装下面这几个最基本的组件,包括 GPU 驱动和 CUDA、DCGM 监控、Kueue 排队、KubeRay 调度、持久化存储,再加监控和日志等。
当然,组件装好只是开始,它们不会自动组合到一起。要让它们互相配合,还得写一堆胶水代码:提交脚本、队列封装、GPU 异常监控、checkpoint 跟 PVC 的绑定。这儿每个点单独看都不难,但要全部串起来,让整套系统稳定可靠地运行,复杂度并不低。
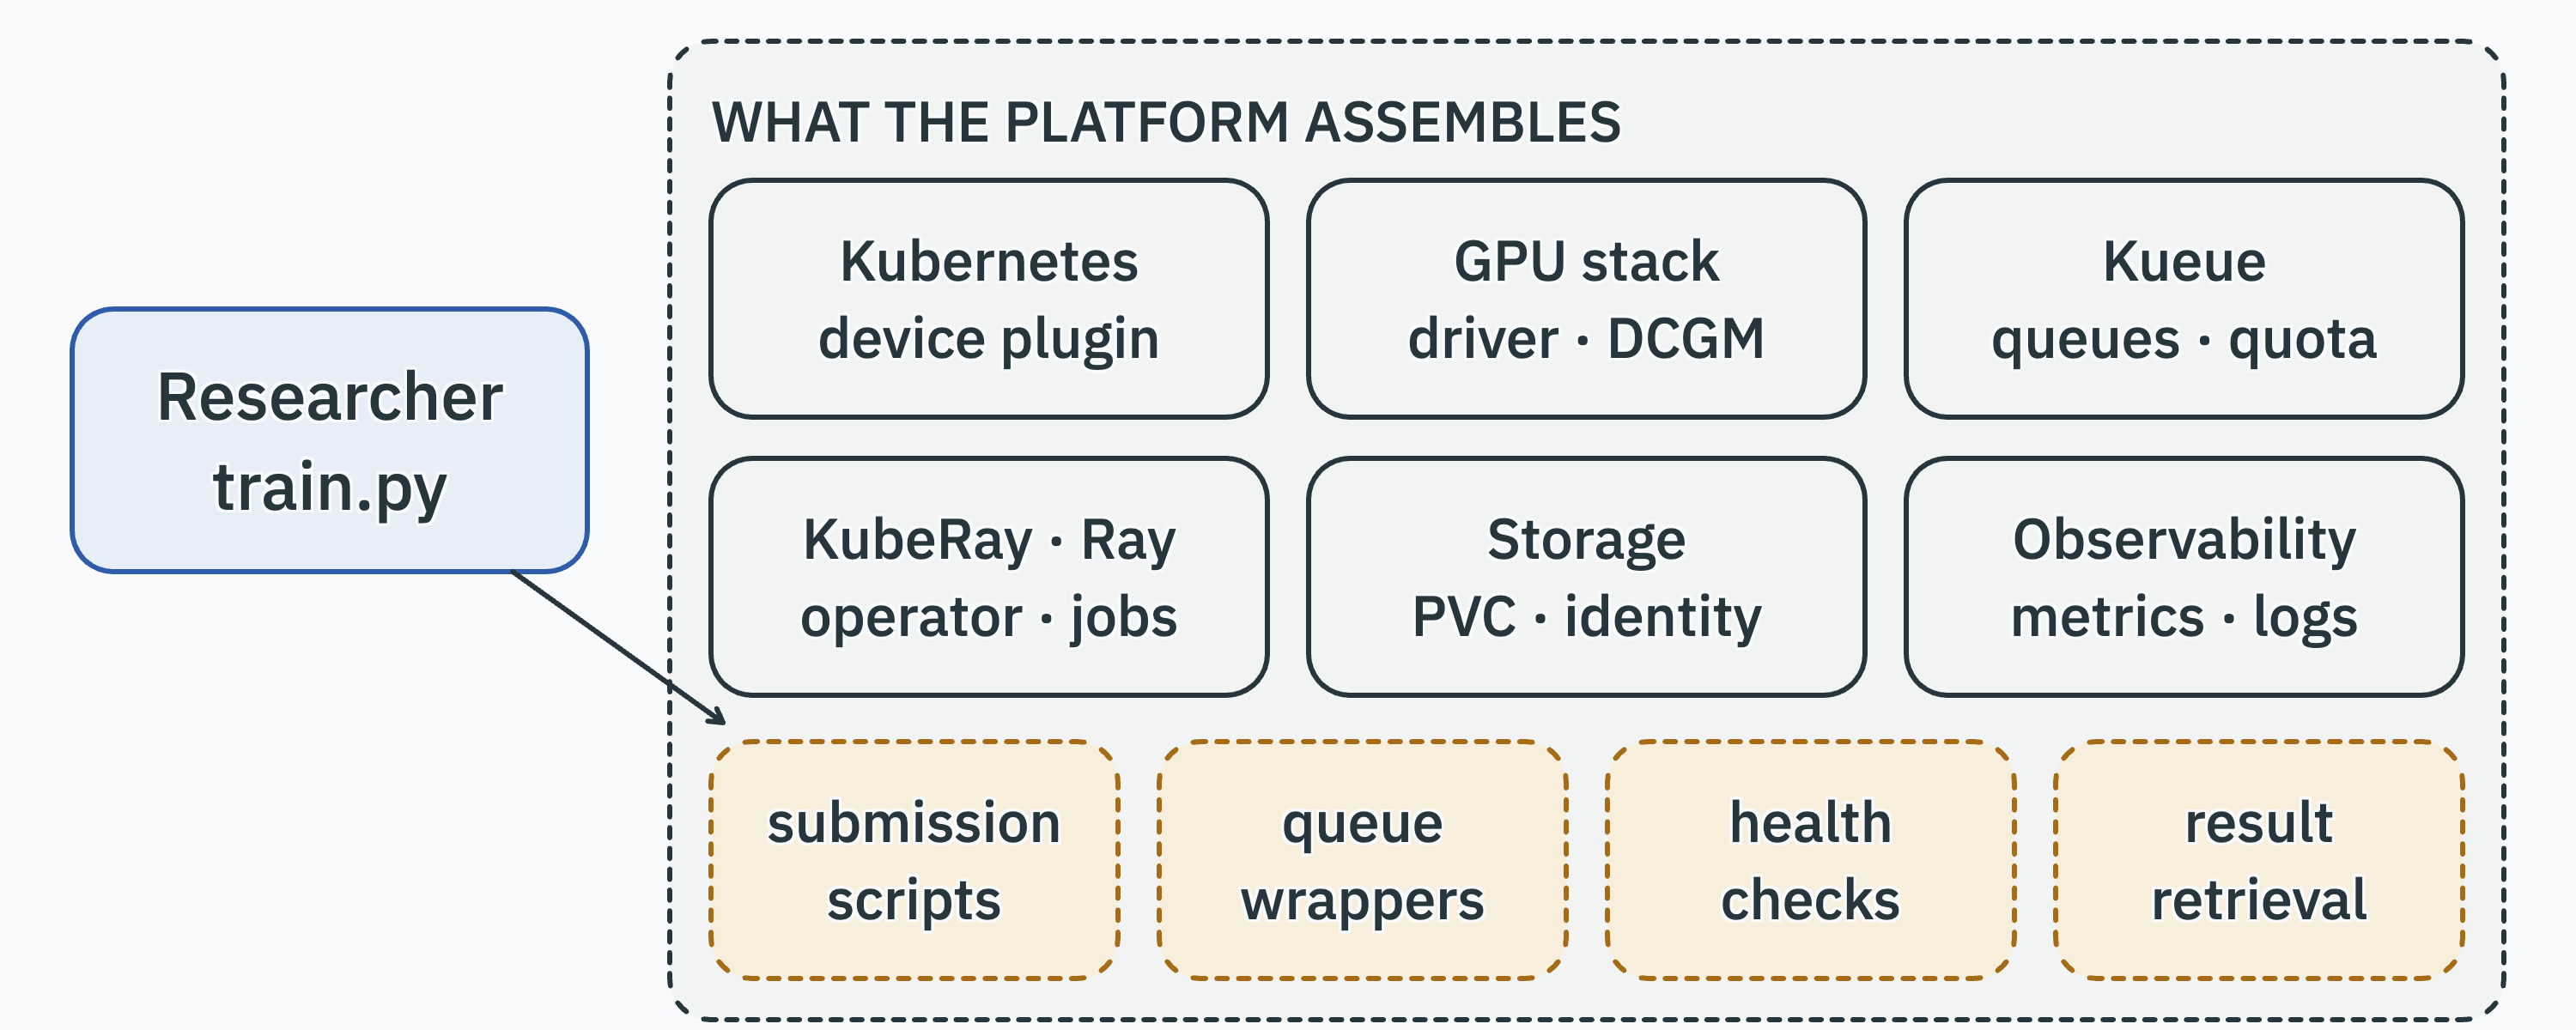
我们在 AKS 上看到很多客户也都是这么走过来的,脚本越堆越多,系统越来越脆弱,维护、升级和异常处理也变得越来越重。
如何解决这个问题呢?其实,把问题拆开看就很清楚了:
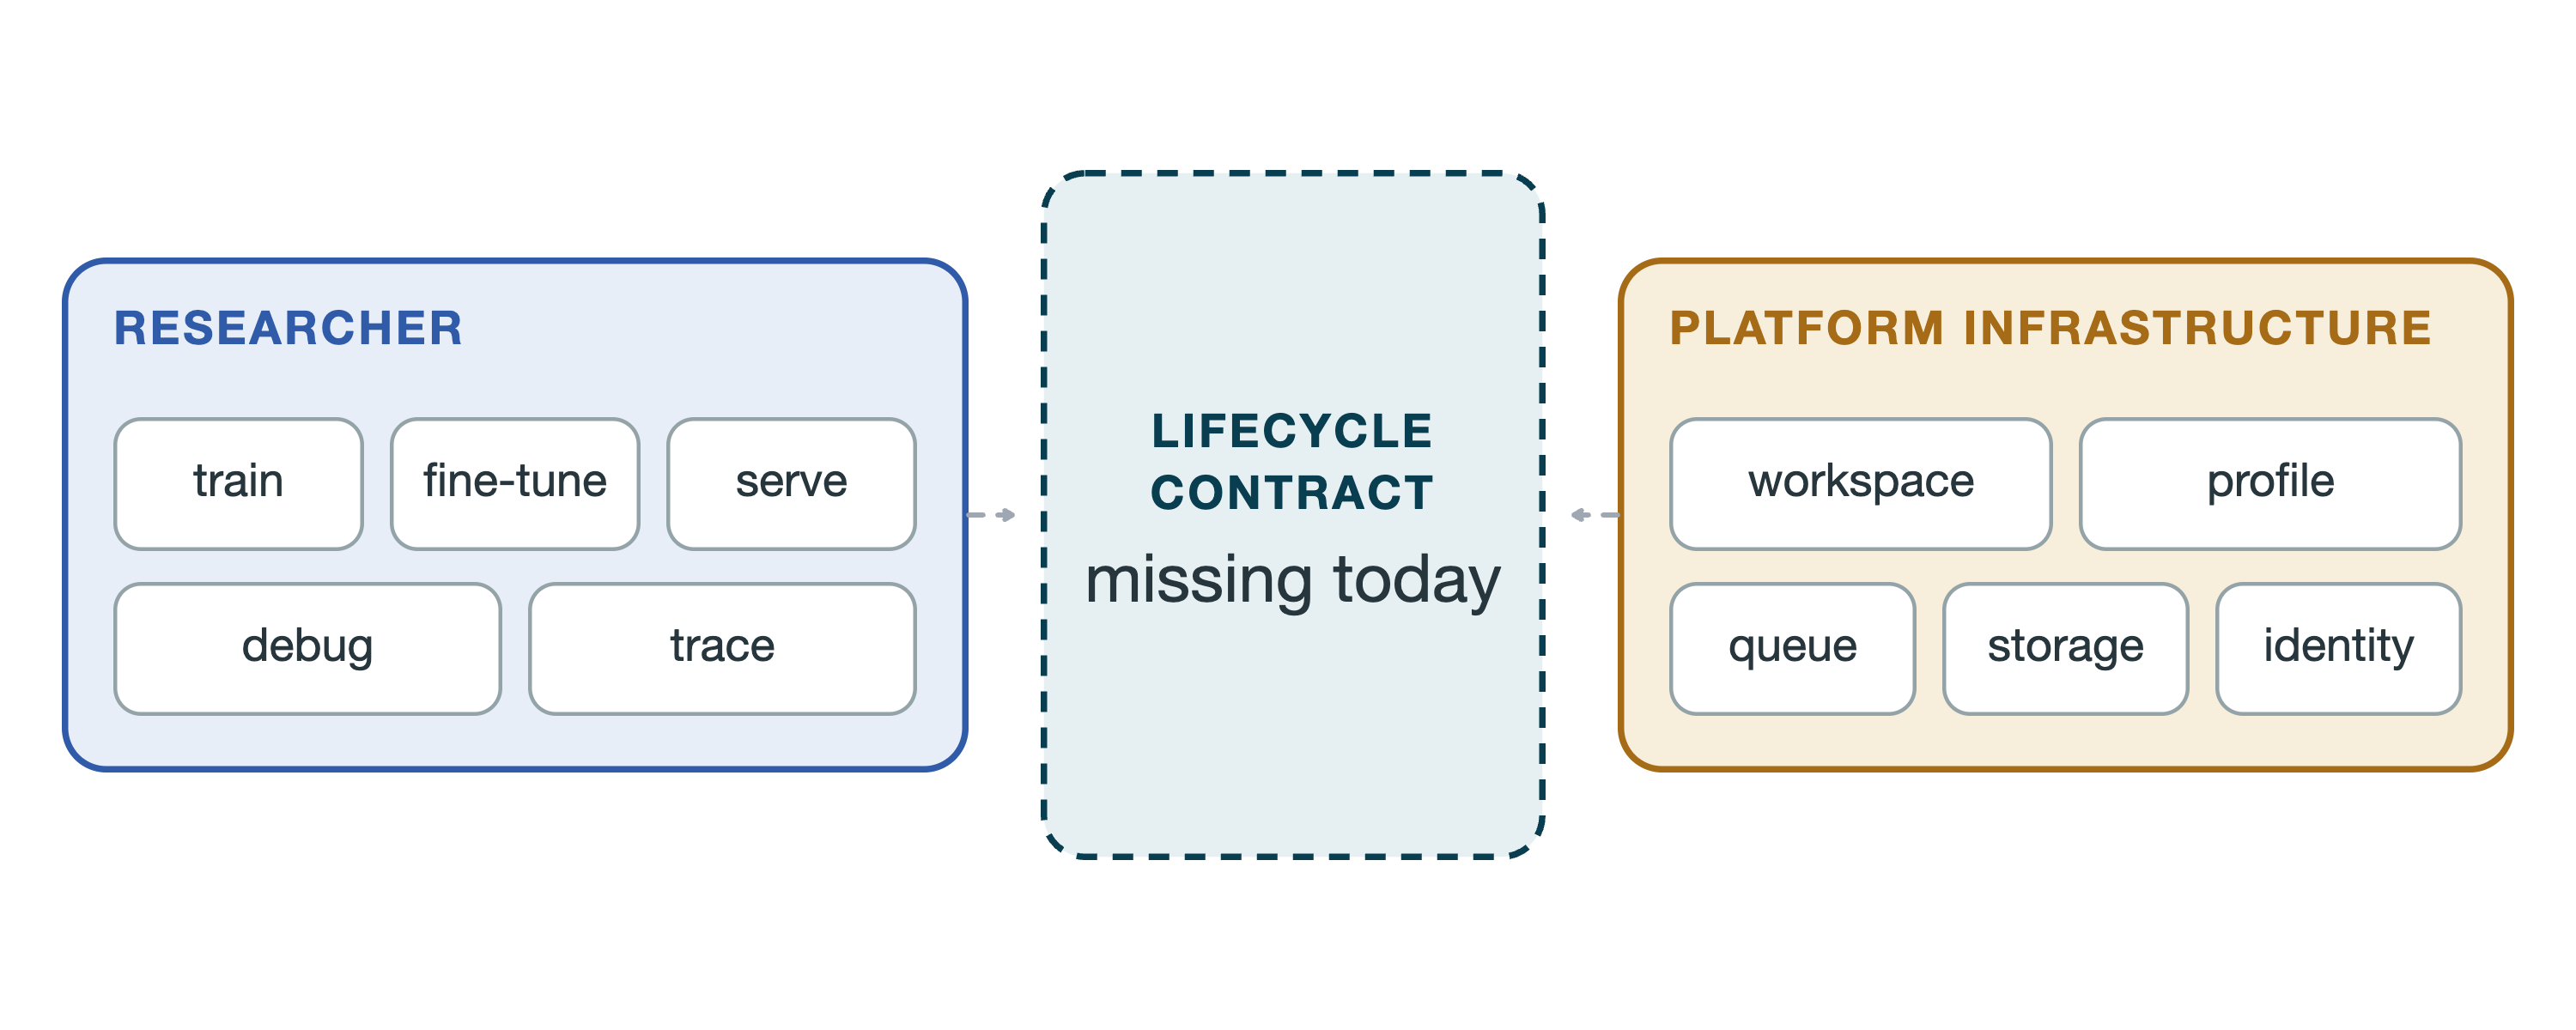
研究员关心的是 AI 训练任务能不能跑、进度怎么样、出了问题去哪看日志。他不需要也不应该关心 Kubernetes 底层跑了什么组件、每个组件到底是什么原理。
另一边,平台关心的是 GPU 有多少、分给谁、利用率够不够、坏了怎么恢复。
两边的关注点完全不同,中间缺一个东西把它们连起来,这也就是 TauGrid 诞生的原因。
设计思路
TauGrid 就是在 Kubernetes 上加了一层生命周期管理,让研究员和平台团队各看各的界面,各管各的事。
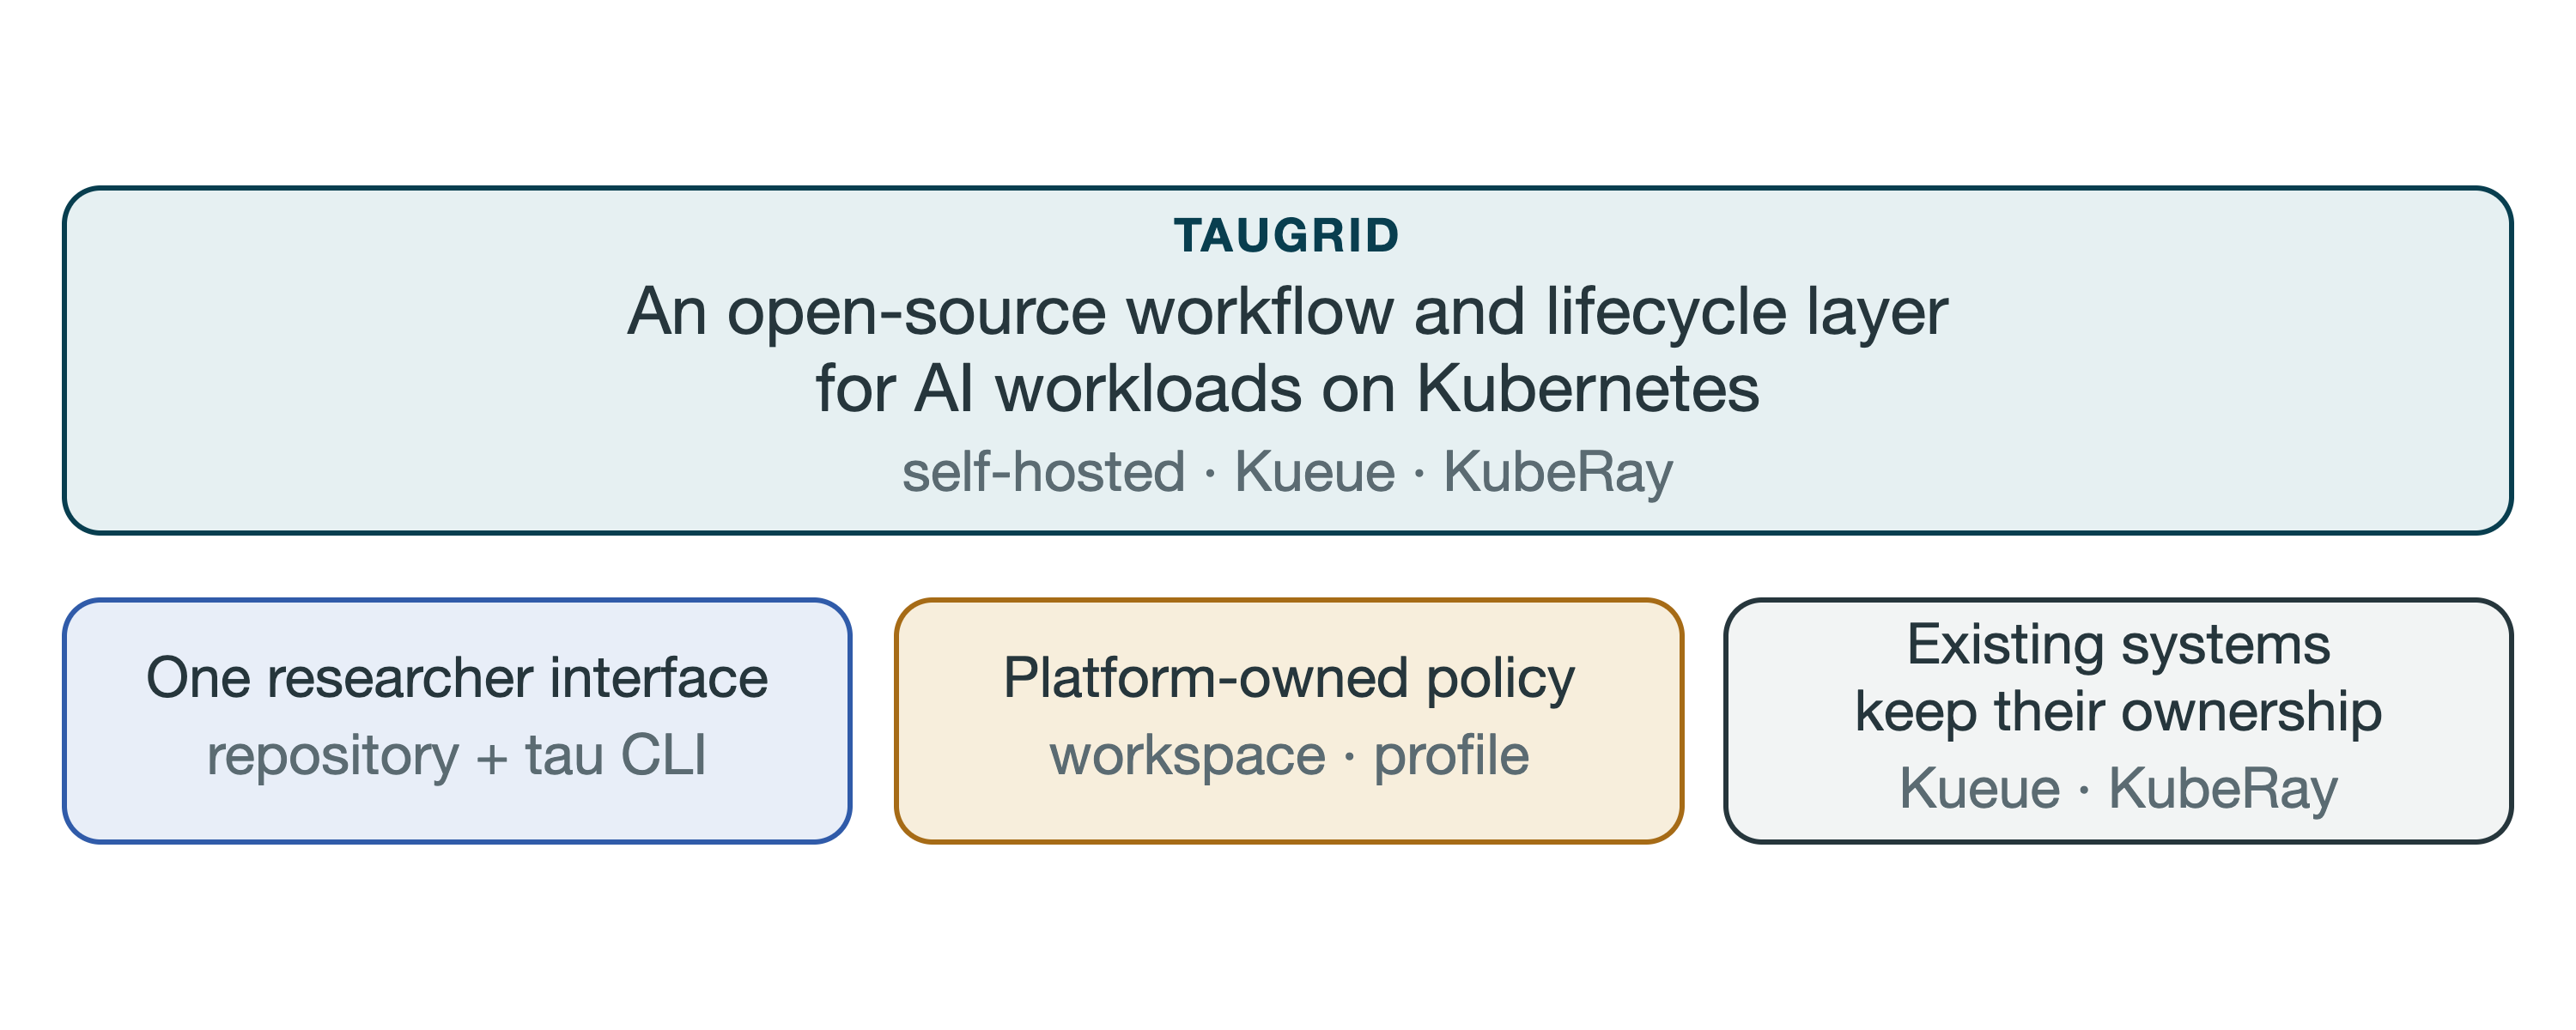
研究员这边,维护一份 tau.yaml,用 tau 命令提交任务、看进度、拿结果,全程不碰 kubectl。平台这边,GPU 类型、配额、队列、节点规格统一配好,研究员不用操心。
有一点我在演讲里特别强调了:TauGrid 没有重新造轮子。排队还是 Kueue,分布式训练还是 KubeRay,GPU 监控还是 DCGM。这些上游项目我们一行都没改,TauGrid 只是把它们串到一起,具体的架构如下所示:
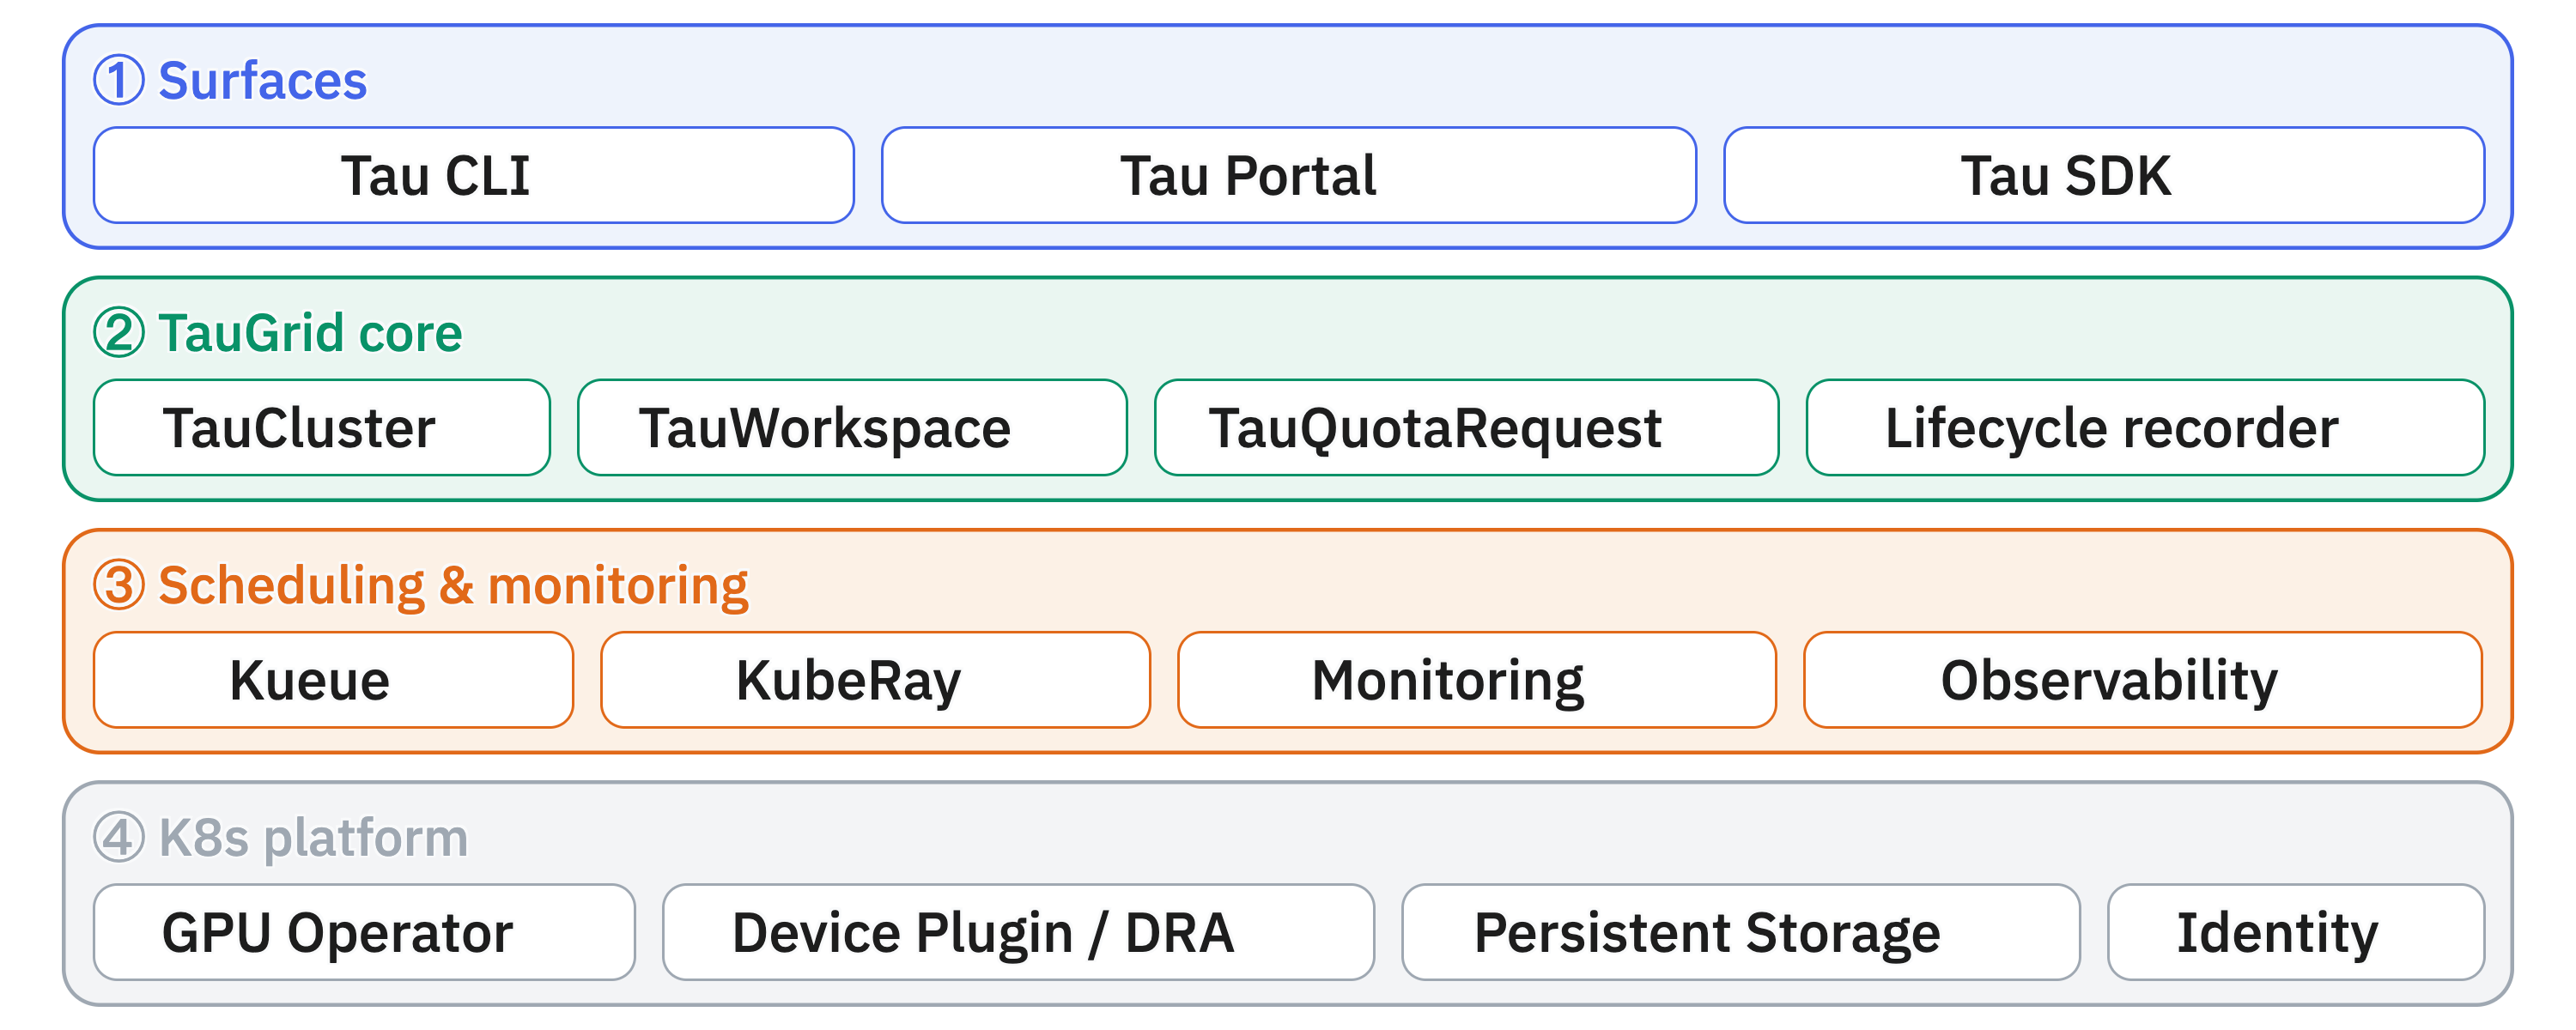
从下往上看,最底下是 Kubernetes 平台本身,GPU Operator、Device Plugin、存储、身份认证这些,集群里本来就有。再往上是调度和观测,接的全是熟面孔:Kueue、KubeRay、DCGM、NPD,这都是社区开源版本。
TauGrid 真正新增的只有上面两层。一层是核心,由几个 CRD 对象加一个 Lifecycle recorder 组成,后面会展开。最上面是用户入口:tau CLI、Portal、SDK。
工作原理
下面就以一次 AI 实验从提交到结束的完整流程为例,看看每个阶段是如何管理的,TauGrid 又是如何解决前面提到的问题的。
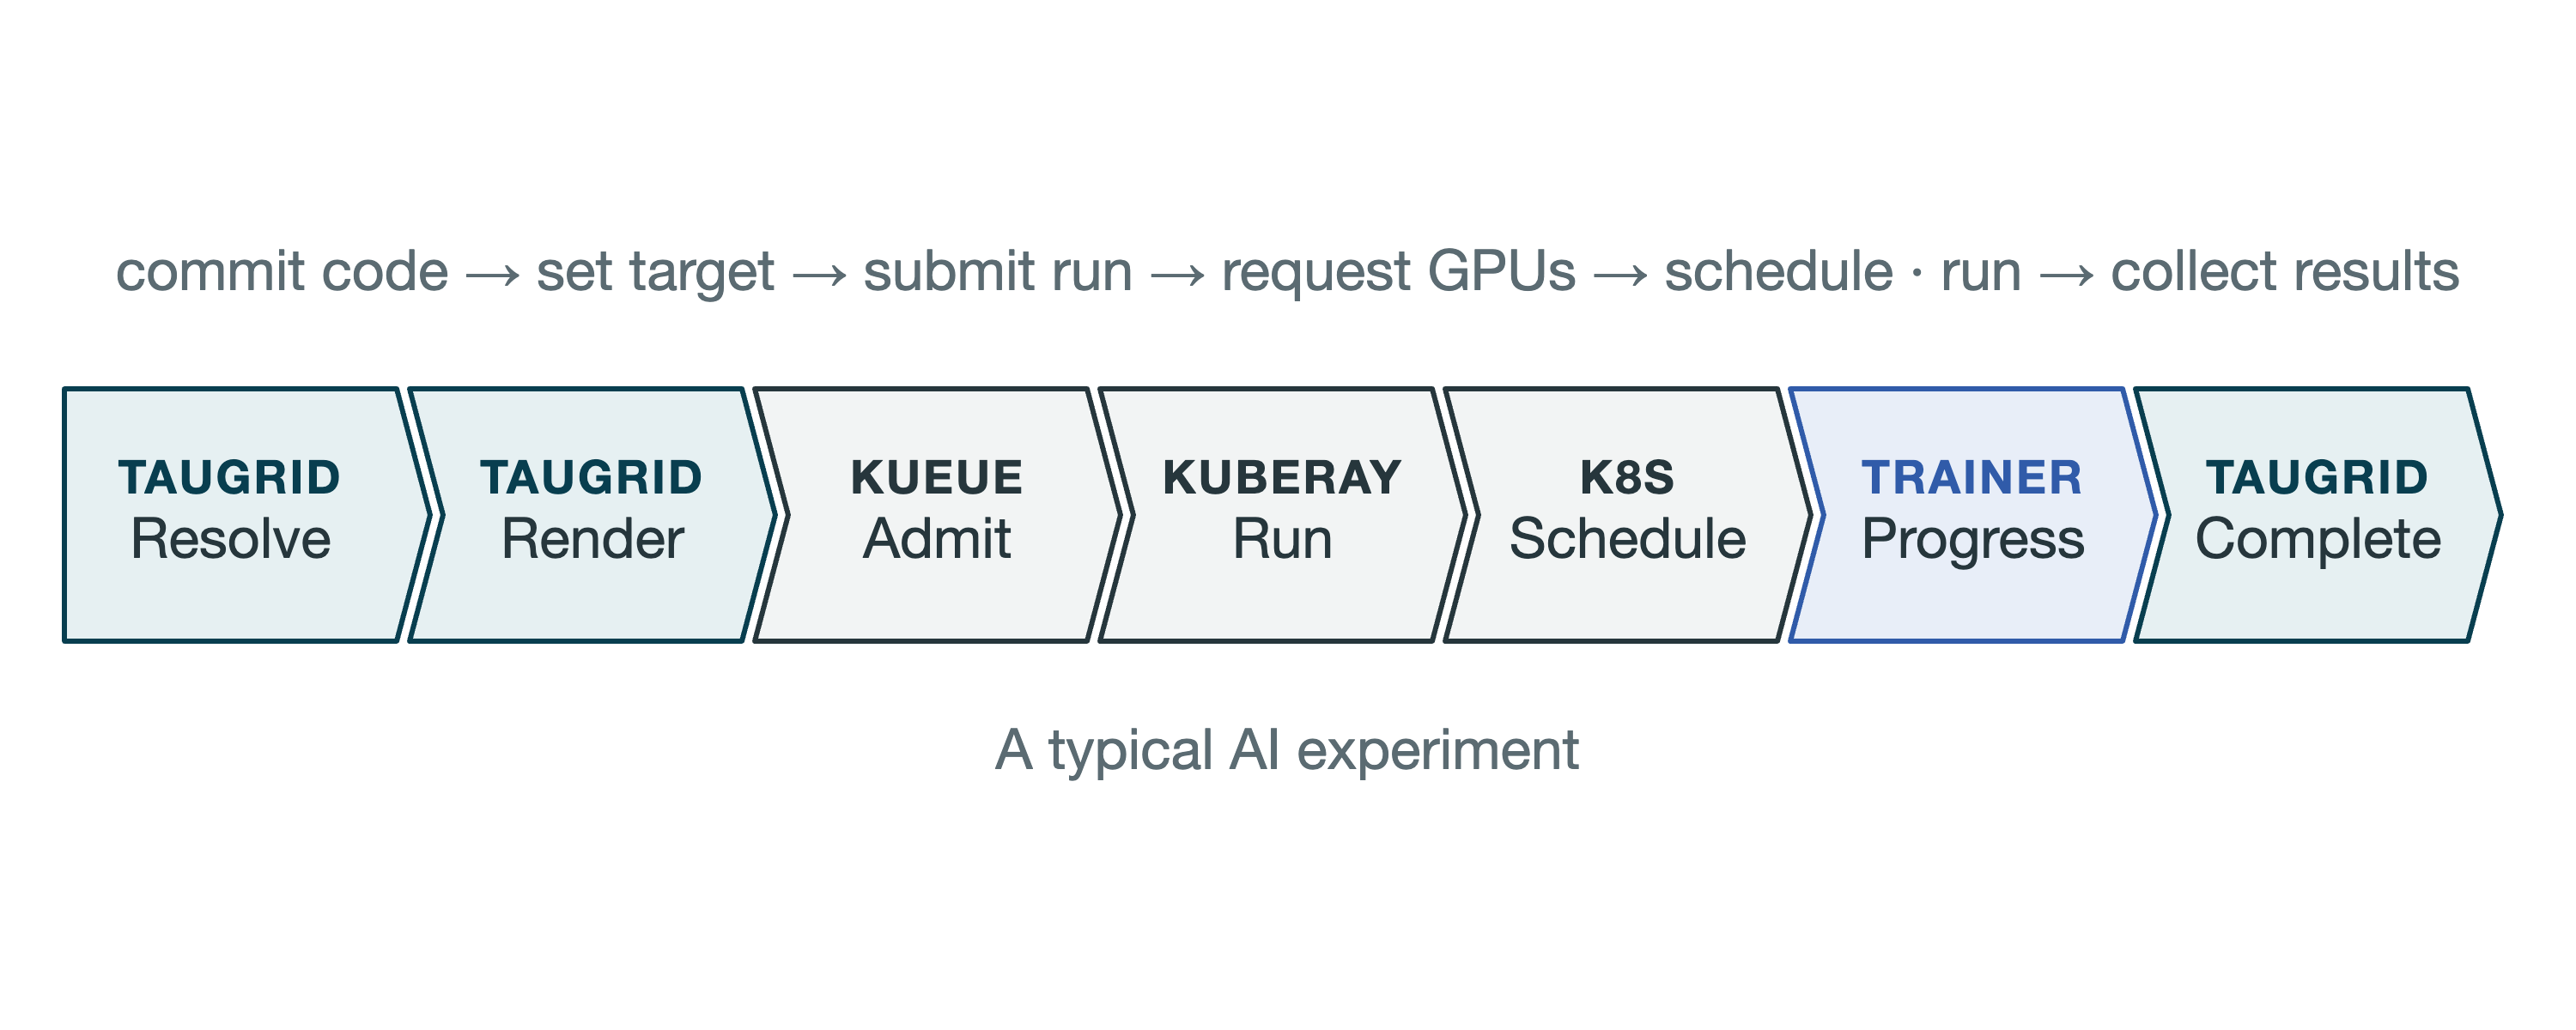
一个典型的 AI 实验,从提交代码到拿回结果,经过七个阶段。前两段 Resolve 和 Render 是 TauGrid 自己的,把研究员的 tau.yaml 和平台的 profile 合成一个 RayJob。然后交给 Kueue 检查配额,KubeRay 拉起集群,Kubernetes 调度到 GPU 节点,训练代码跑起来,最后 TauGrid 确认结束、回收资源。
虽然执行分散在不同系统里,但观测一直在进行。TauGrid 从提交开始就把状态、日志、训练指标一路抓回来,研究员在 CLI 和 Portal 里能实时看到 loss 曲线。平台那边,DCGM 和 NPD 也一直在抓 GPU 健康状况和使用率。
存储契约
这些阶段是怎么串起来的呢?靠两样东西。第一样是持久化存储。
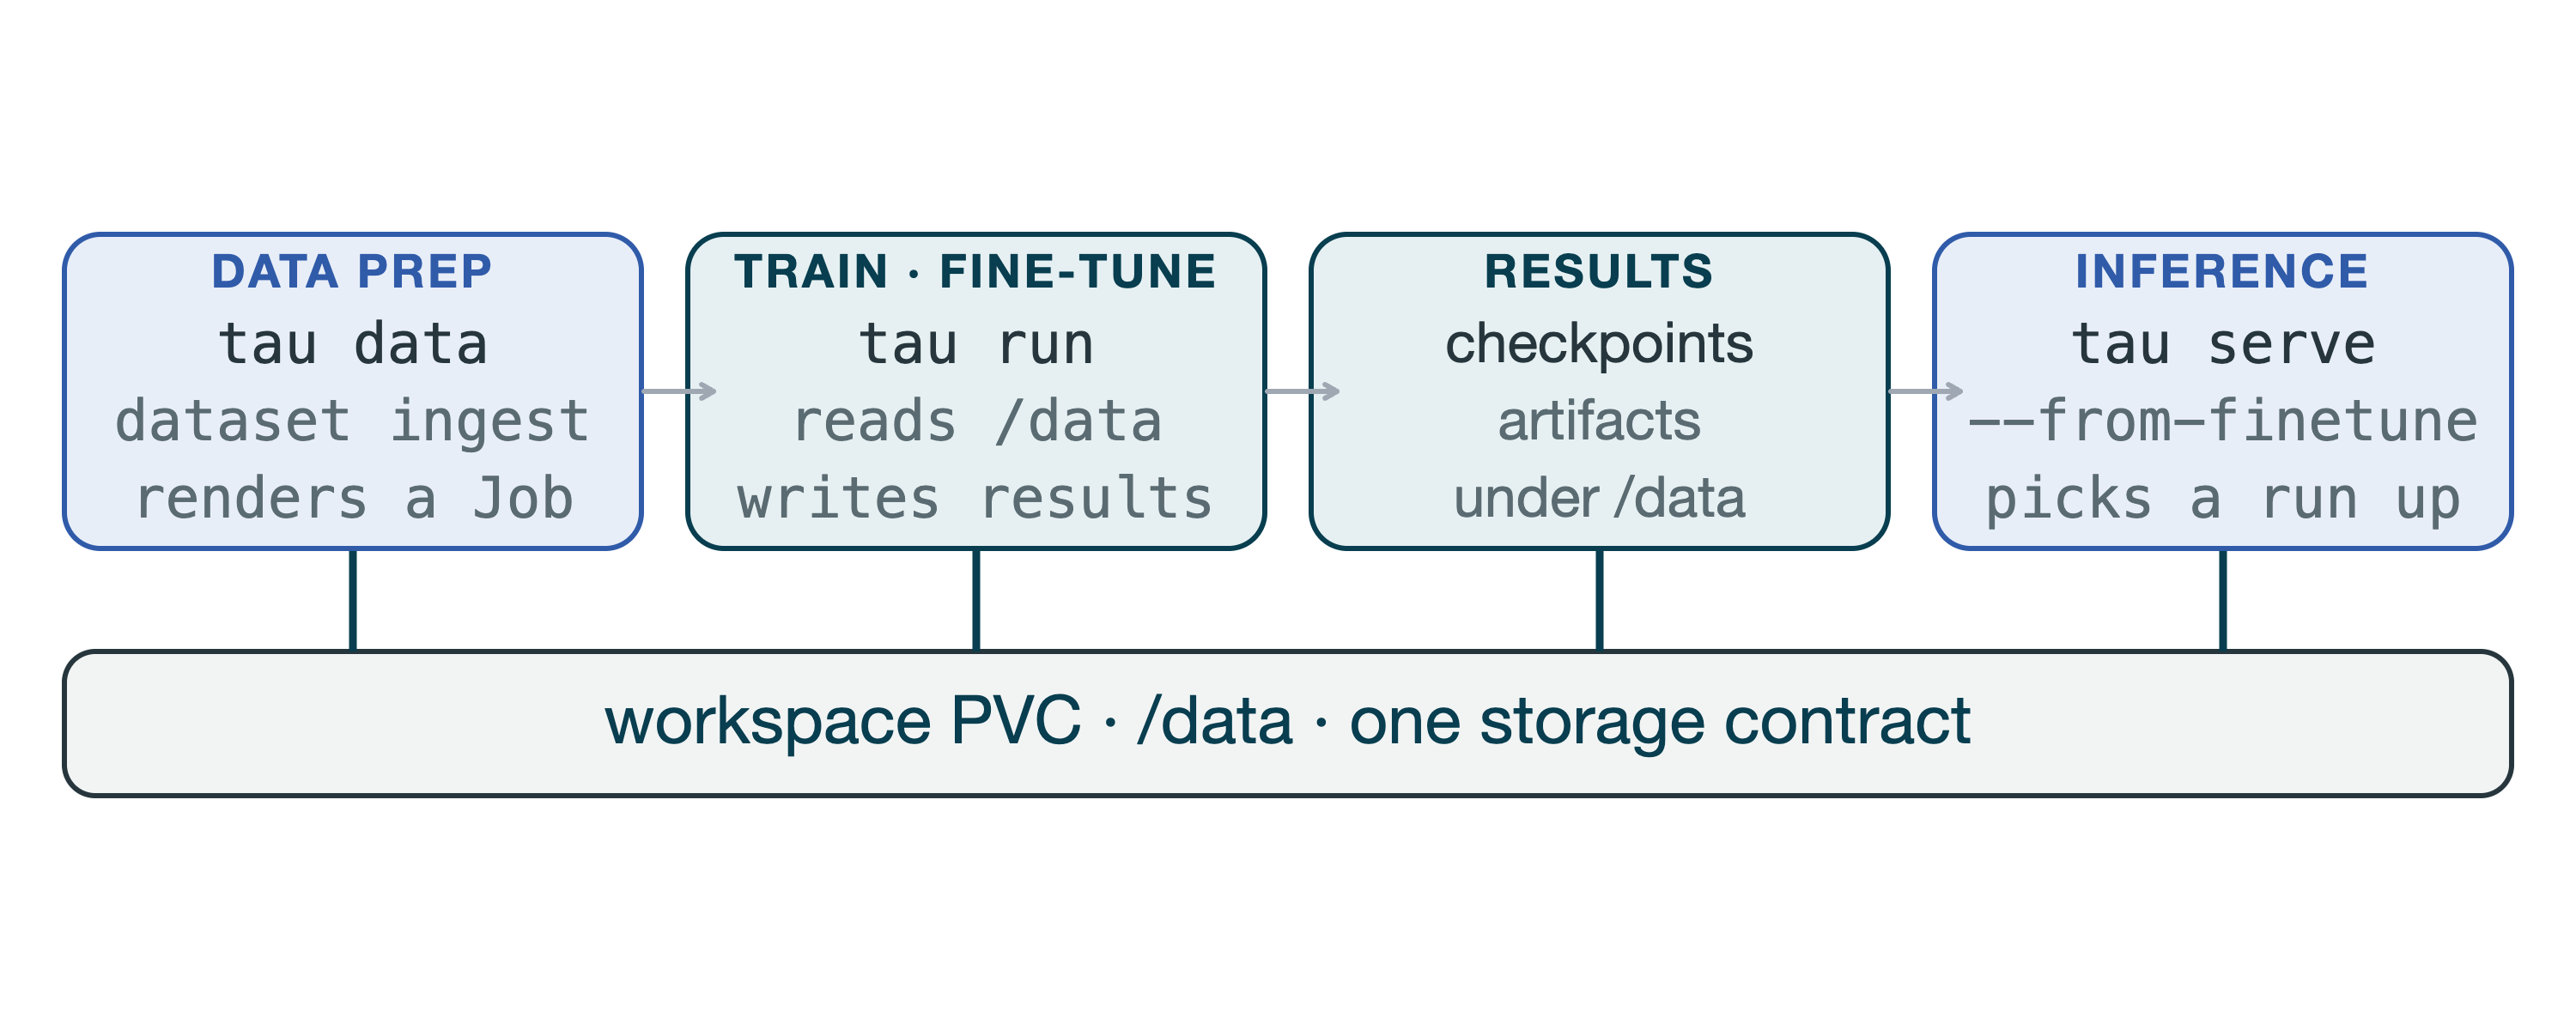
同一个 workspace 下的所有任务共享一块 PVC,挂在 /data。数据准备用 tau data,训练用 tau run,推理用 tau serve,换的只是命令,存储路径始终是同一个。checkpoint、训练产物、模型文件都按 run ID 组织在 /data 下面。
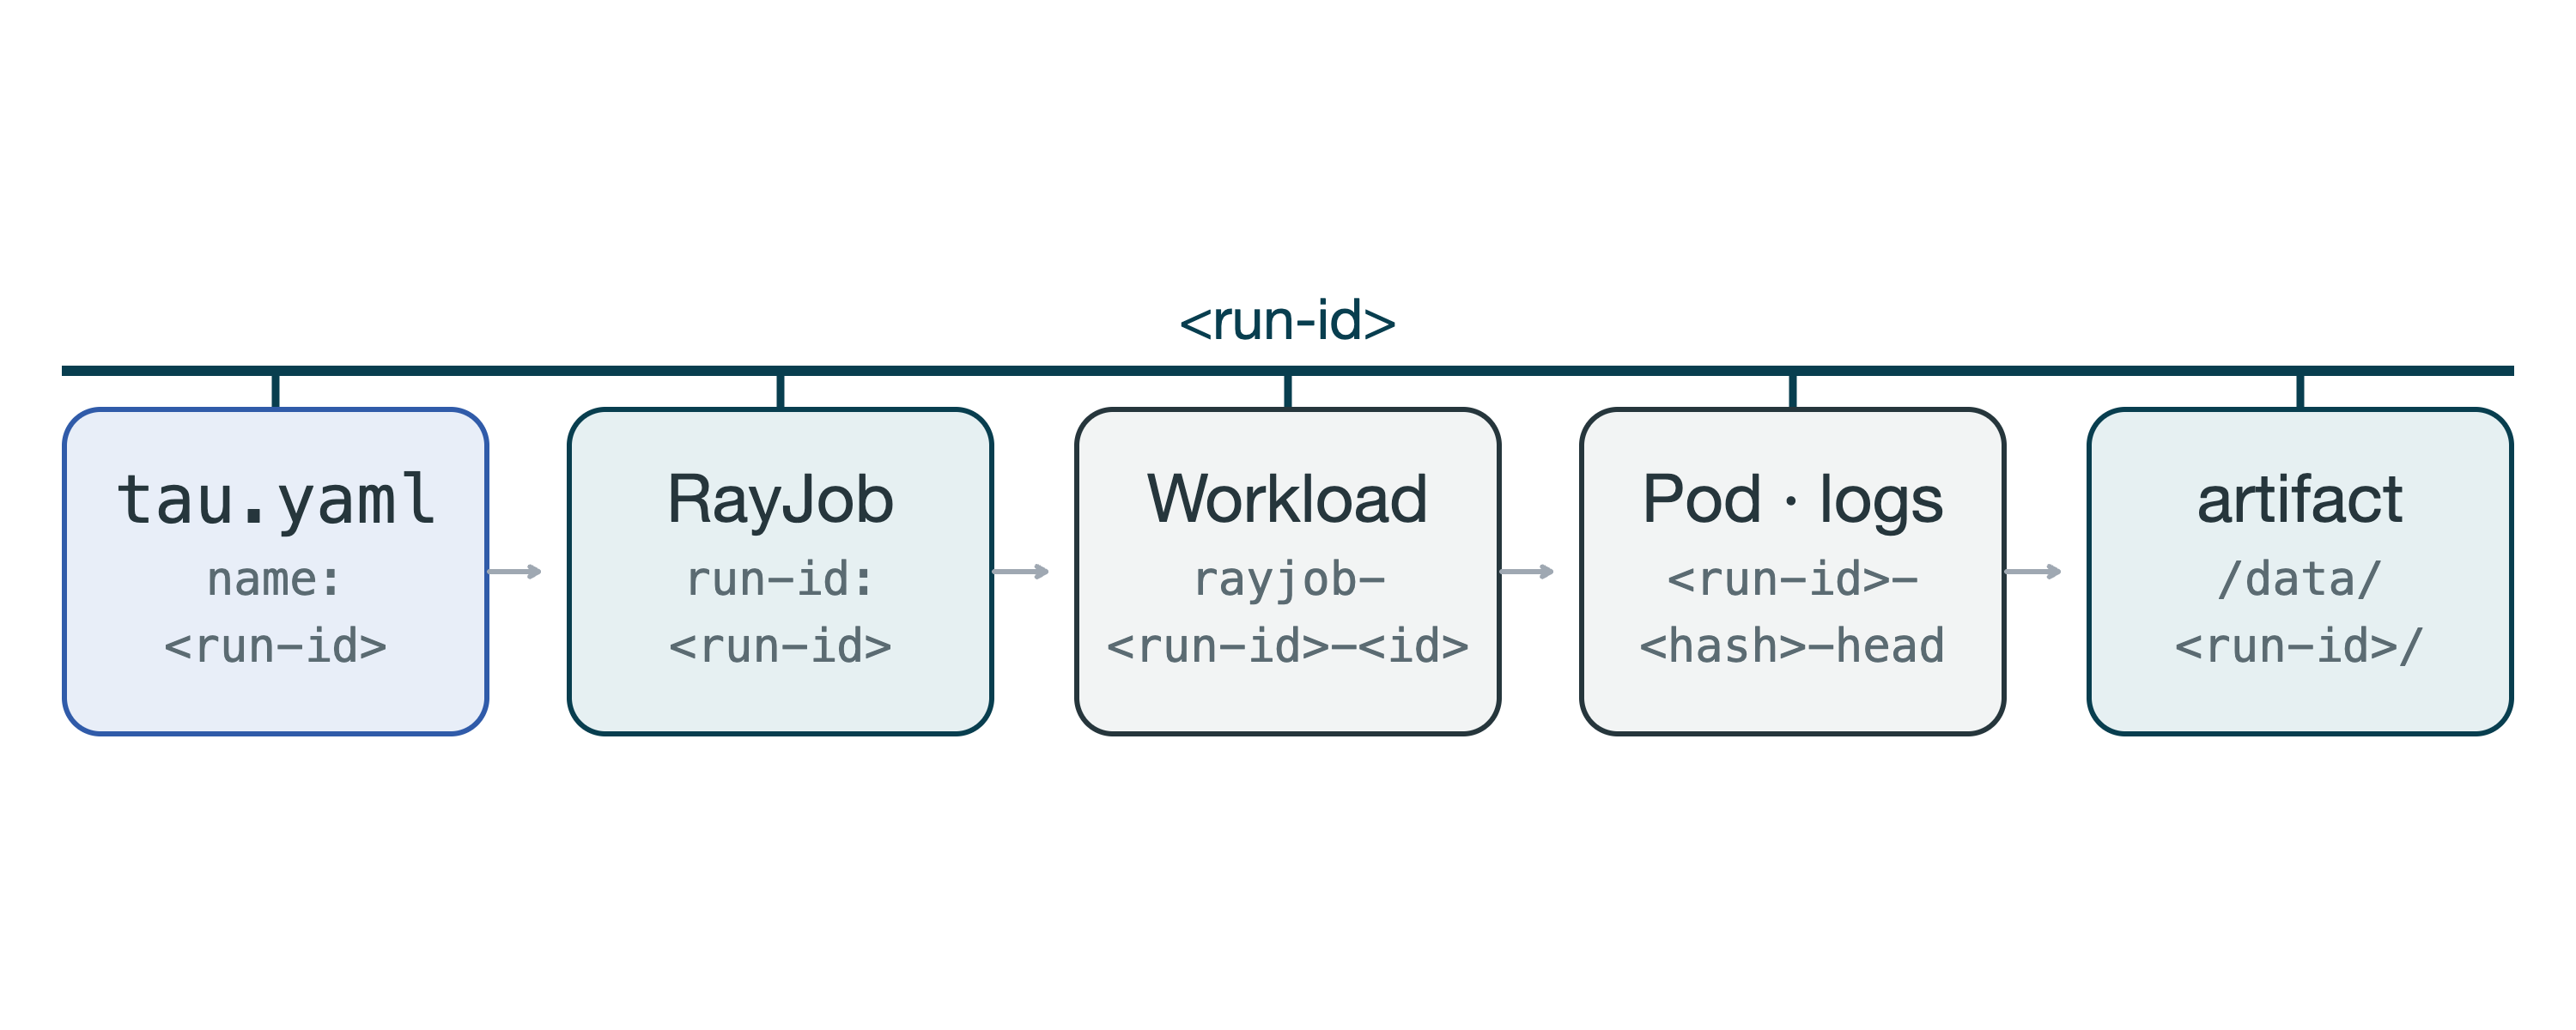
不同的系统组件通过 run ID 标识同一个任务:tau run 渲染出的 RayJob 带上 tau.azure.com/run-id 这个 label,后面 Kueue 的 Workload、RayCluster、Pod 都带着同一个标签,而产物则按 run-id 存放在 /data/
CLI 渲染
第二样是渲染。
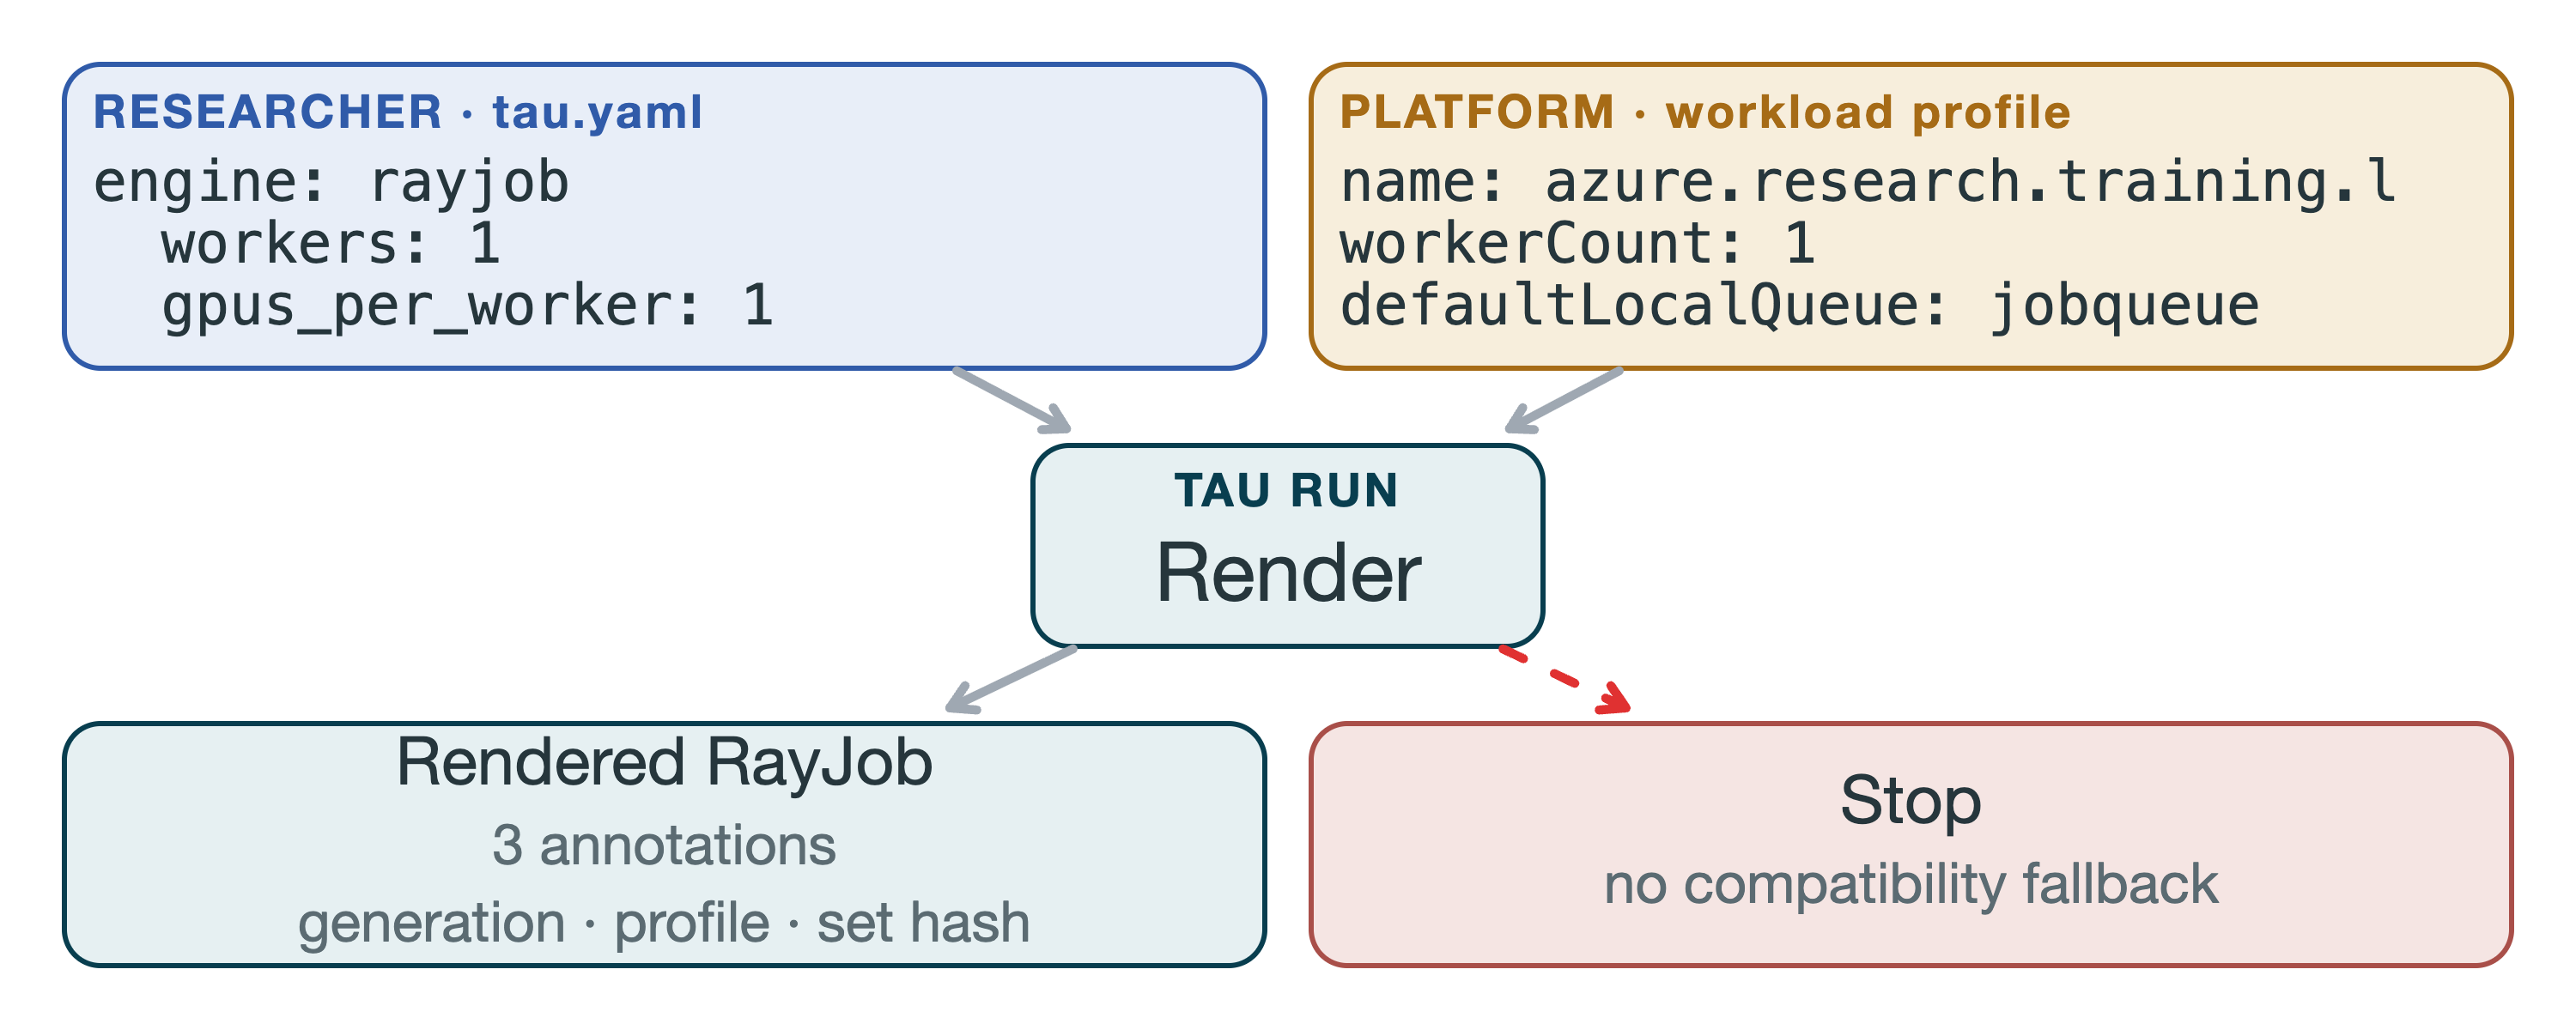
左边是研究员写的 tau.yaml,比如用 rayjob、1 个 worker、每个 worker 1 张卡。右边是平台管理员配置的 workload profile,定义了用什么 GPU 节点、进哪条队列。
tau run 把两边合到一起生成 RayJob,以管理员定义的 profile 为准。研究员配置的 tau.yaml 有问题时,直接在客户端报错,避免了提交后才发现 GPU 资源不足、任务配置跟节点配置不一致等错误。让错误在提交之前全部暴露出来,不要等跑了半小时才发现一开始就配错了。
TauGrid 控制器
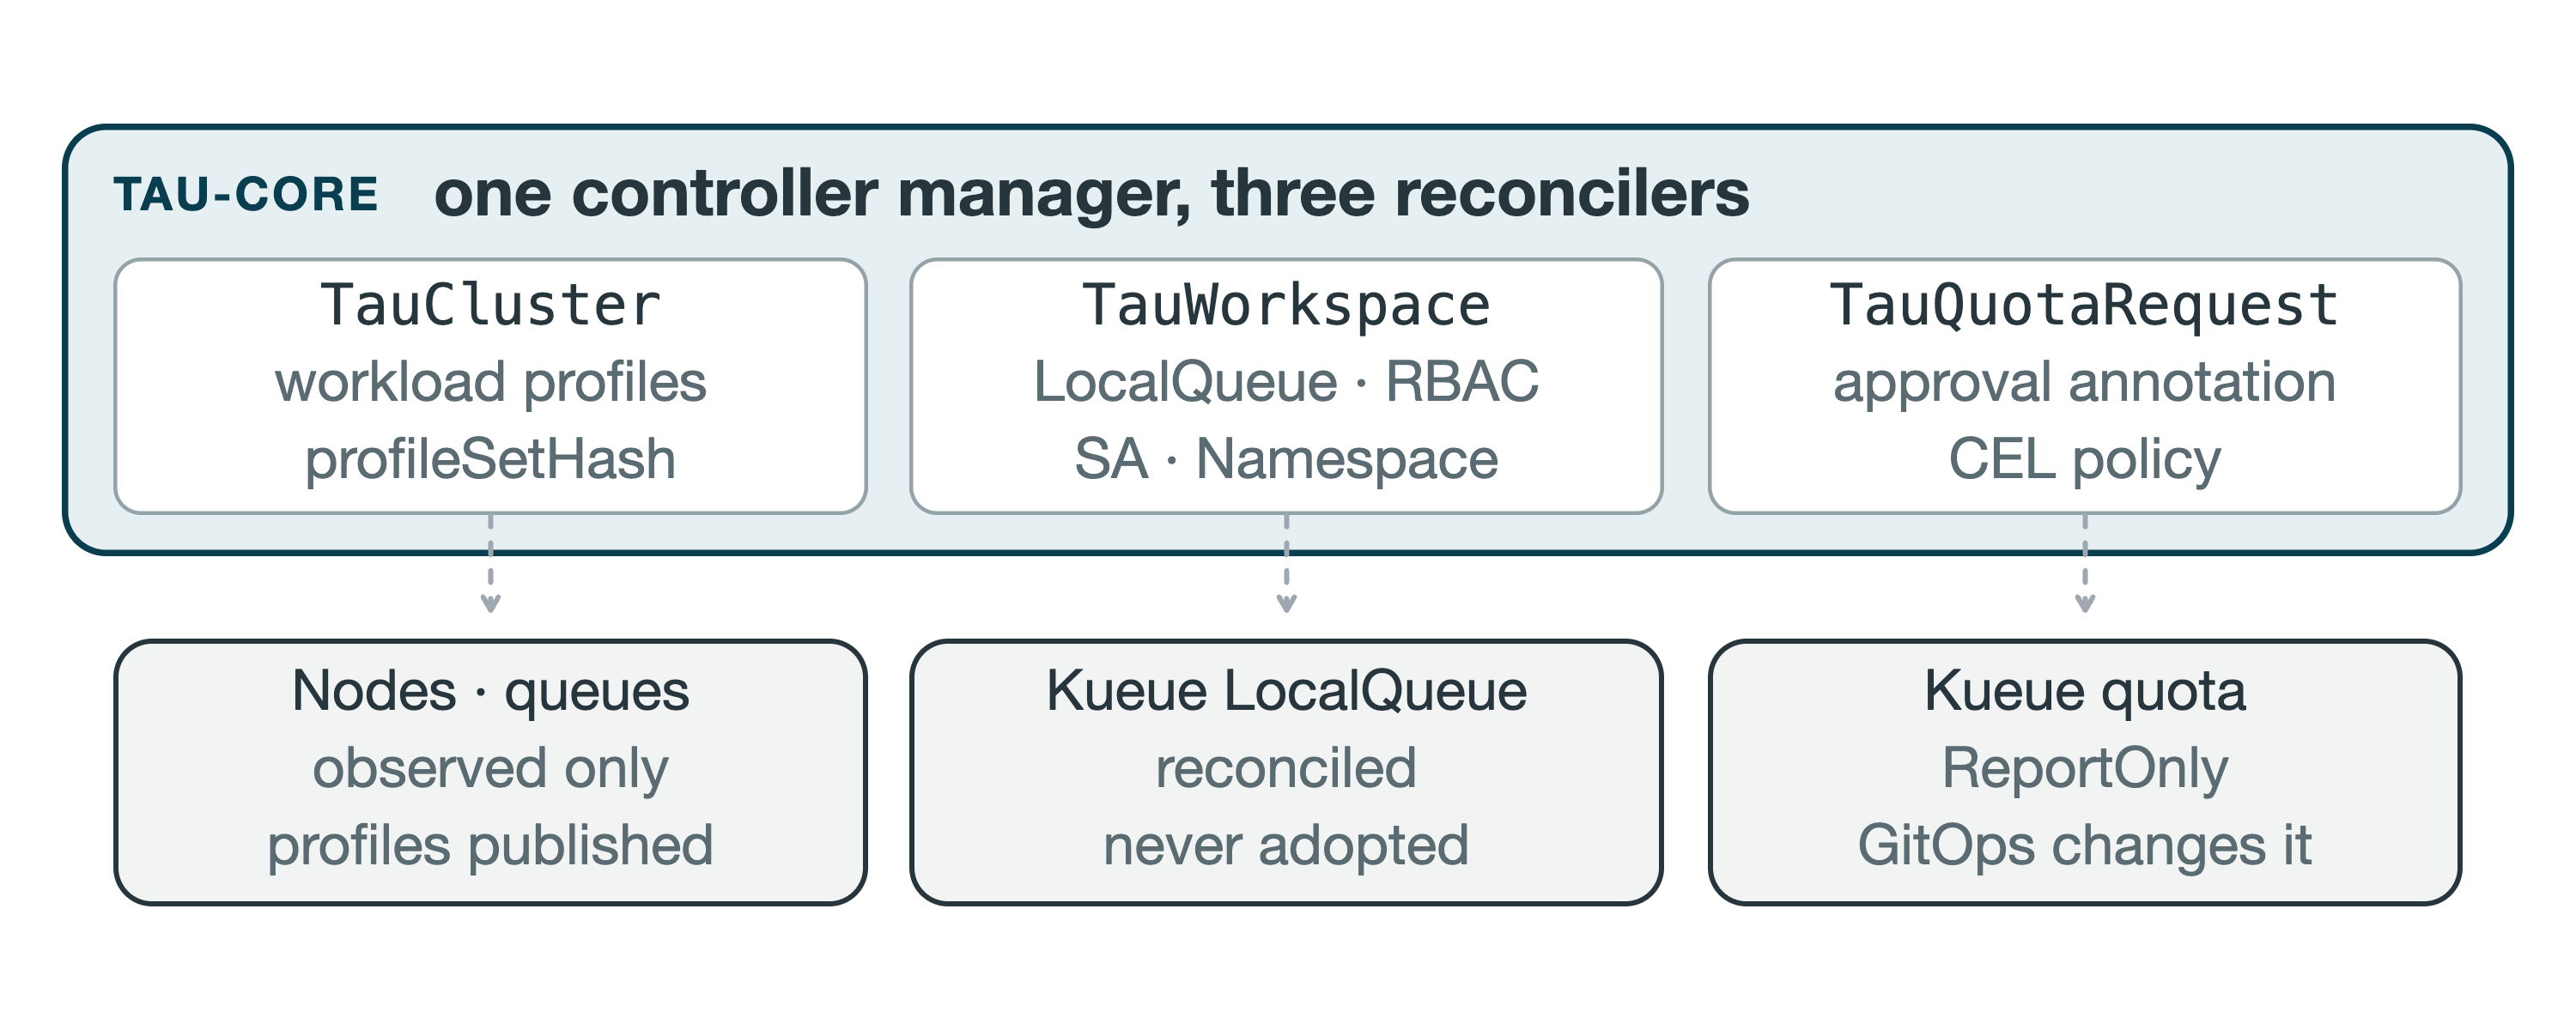
为了把各种组件串联起来,TauGrid 引入了三个 CRD 对象:
TauCluster 管理集群里有哪些 GPU、什么规格、对应哪条队列,控制器盯着节点变化自动发布 workload profile。
TauWorkspace 管研究员的工作空间,把 Namespace、LocalQueue、RBAC、ServiceAccount 一次性准备好。
TauQuotaRequest 管配额申请,研究员提申请,只有平台管理员才可以批准。
它们的具体职责如下图所示:
任务状态
以前一个 Workload 出问题,得去多个系统分别排查。比如配额不足查 Kueue,无法调度看 kube-scheduler,GPU 异常看 Node,任务进度查训练日志,完成状态查 RayJob,最终的产物还要到 PVC 中去看。一个小问题要查这么多系统,无论是 AI 研究员还是平台 SRE 都挺崩溃的。
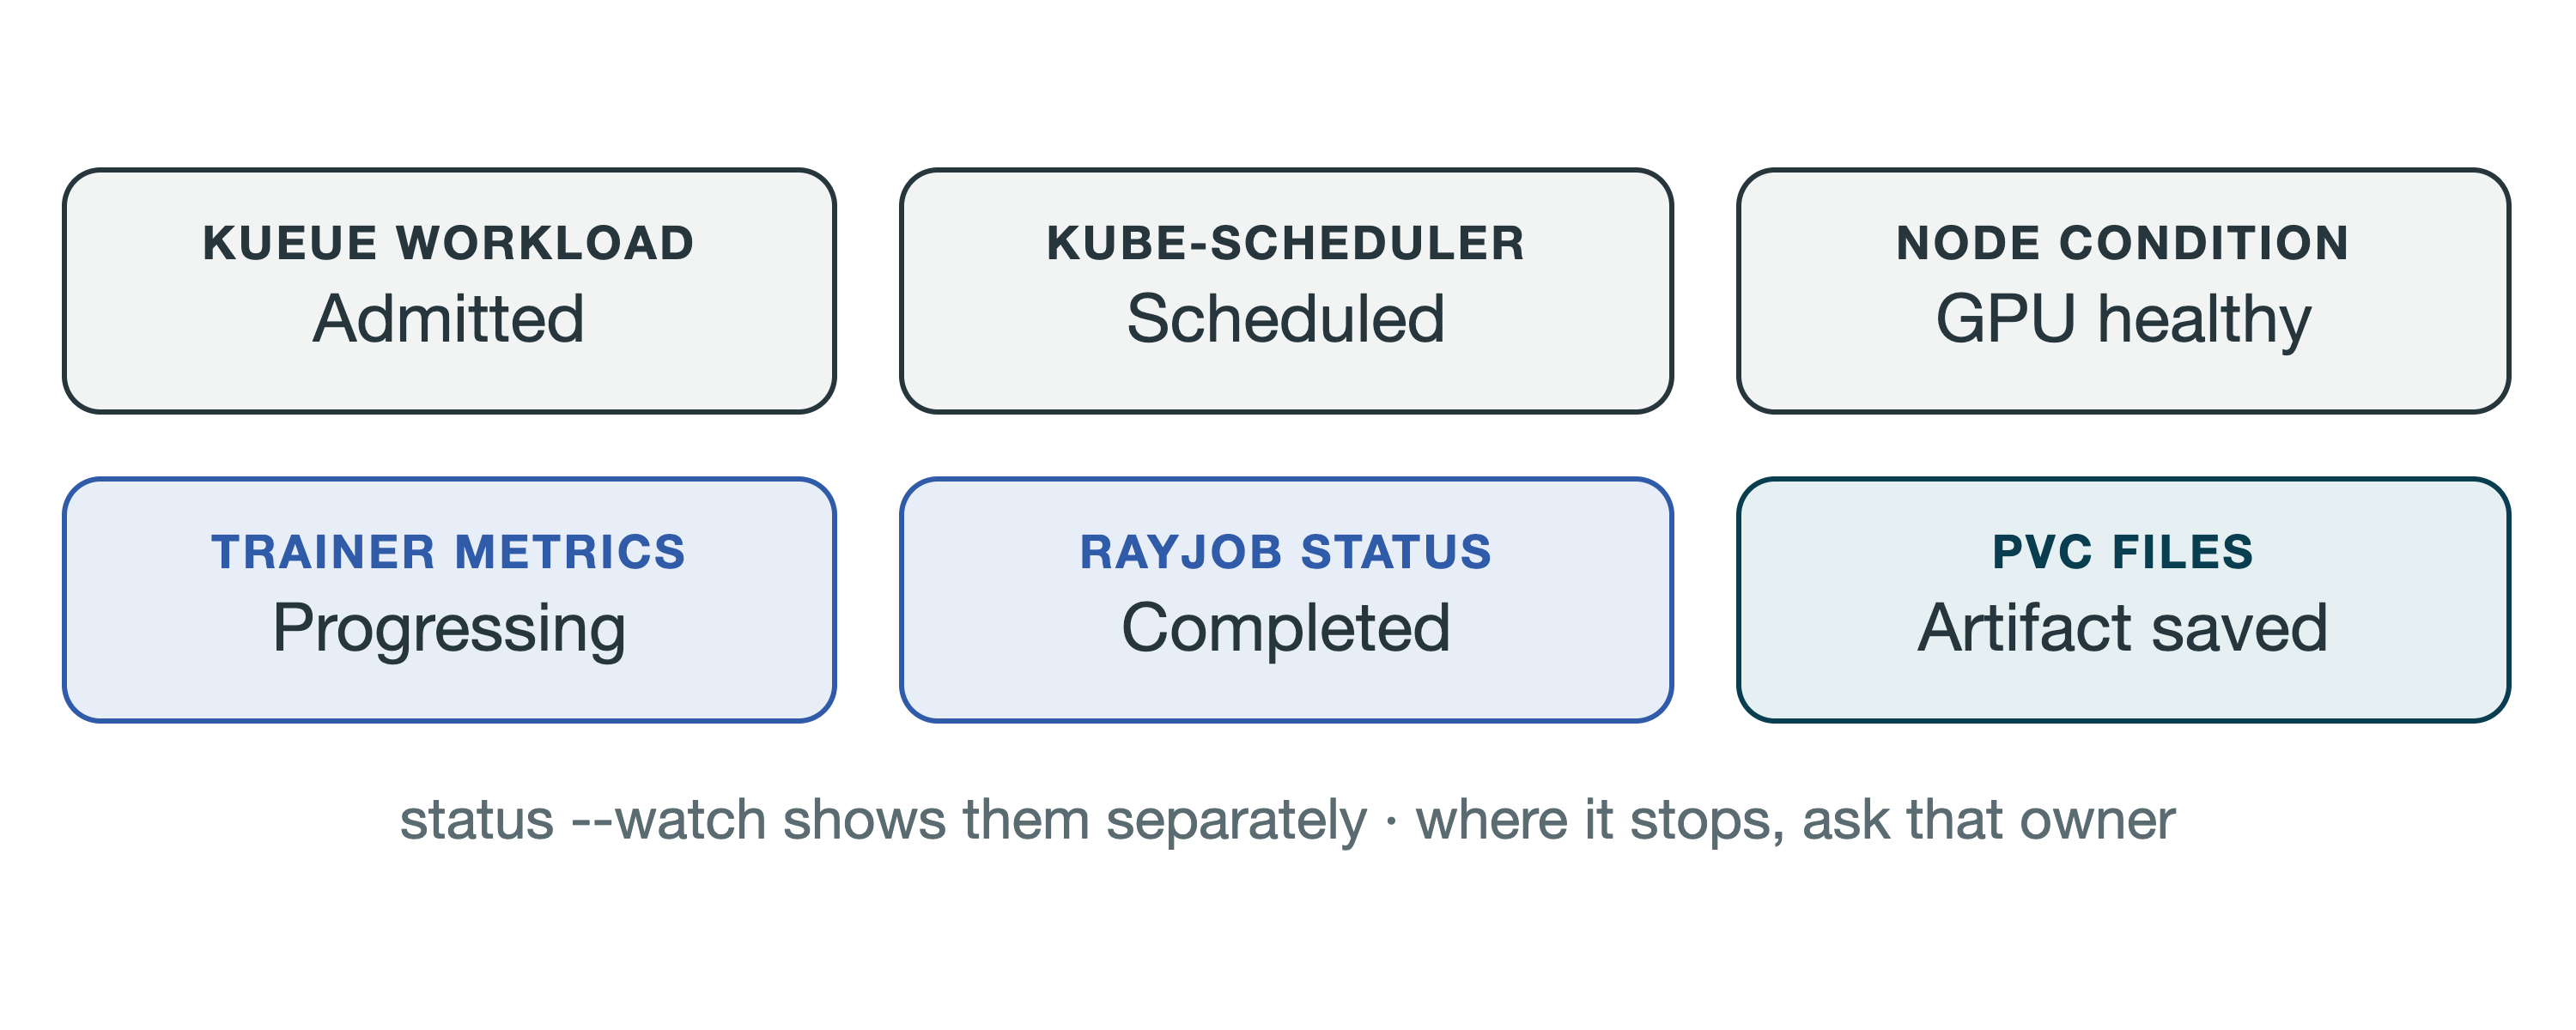
TauGrid 把这些信号收到一起,拆成六个状态:Admitted(来自 Kueue)、Scheduled(来自 kube-scheduler)、GPU healthy(来自节点 condition)、Progressing(来自训练指标)、Completed/Failed(来自 RayJob 状态)、Artifact saved(来自 PVC 文件)。
通过 tau run status 一条命令就能看到异常任务到底卡在哪个阶段,从而快速定位到出问题的组件。
任务结束
研究员的训练任务跑完,并不意味着其他任务就可以直接调度过来接着执行。任务结束后还需要清理资源,分两条线走:
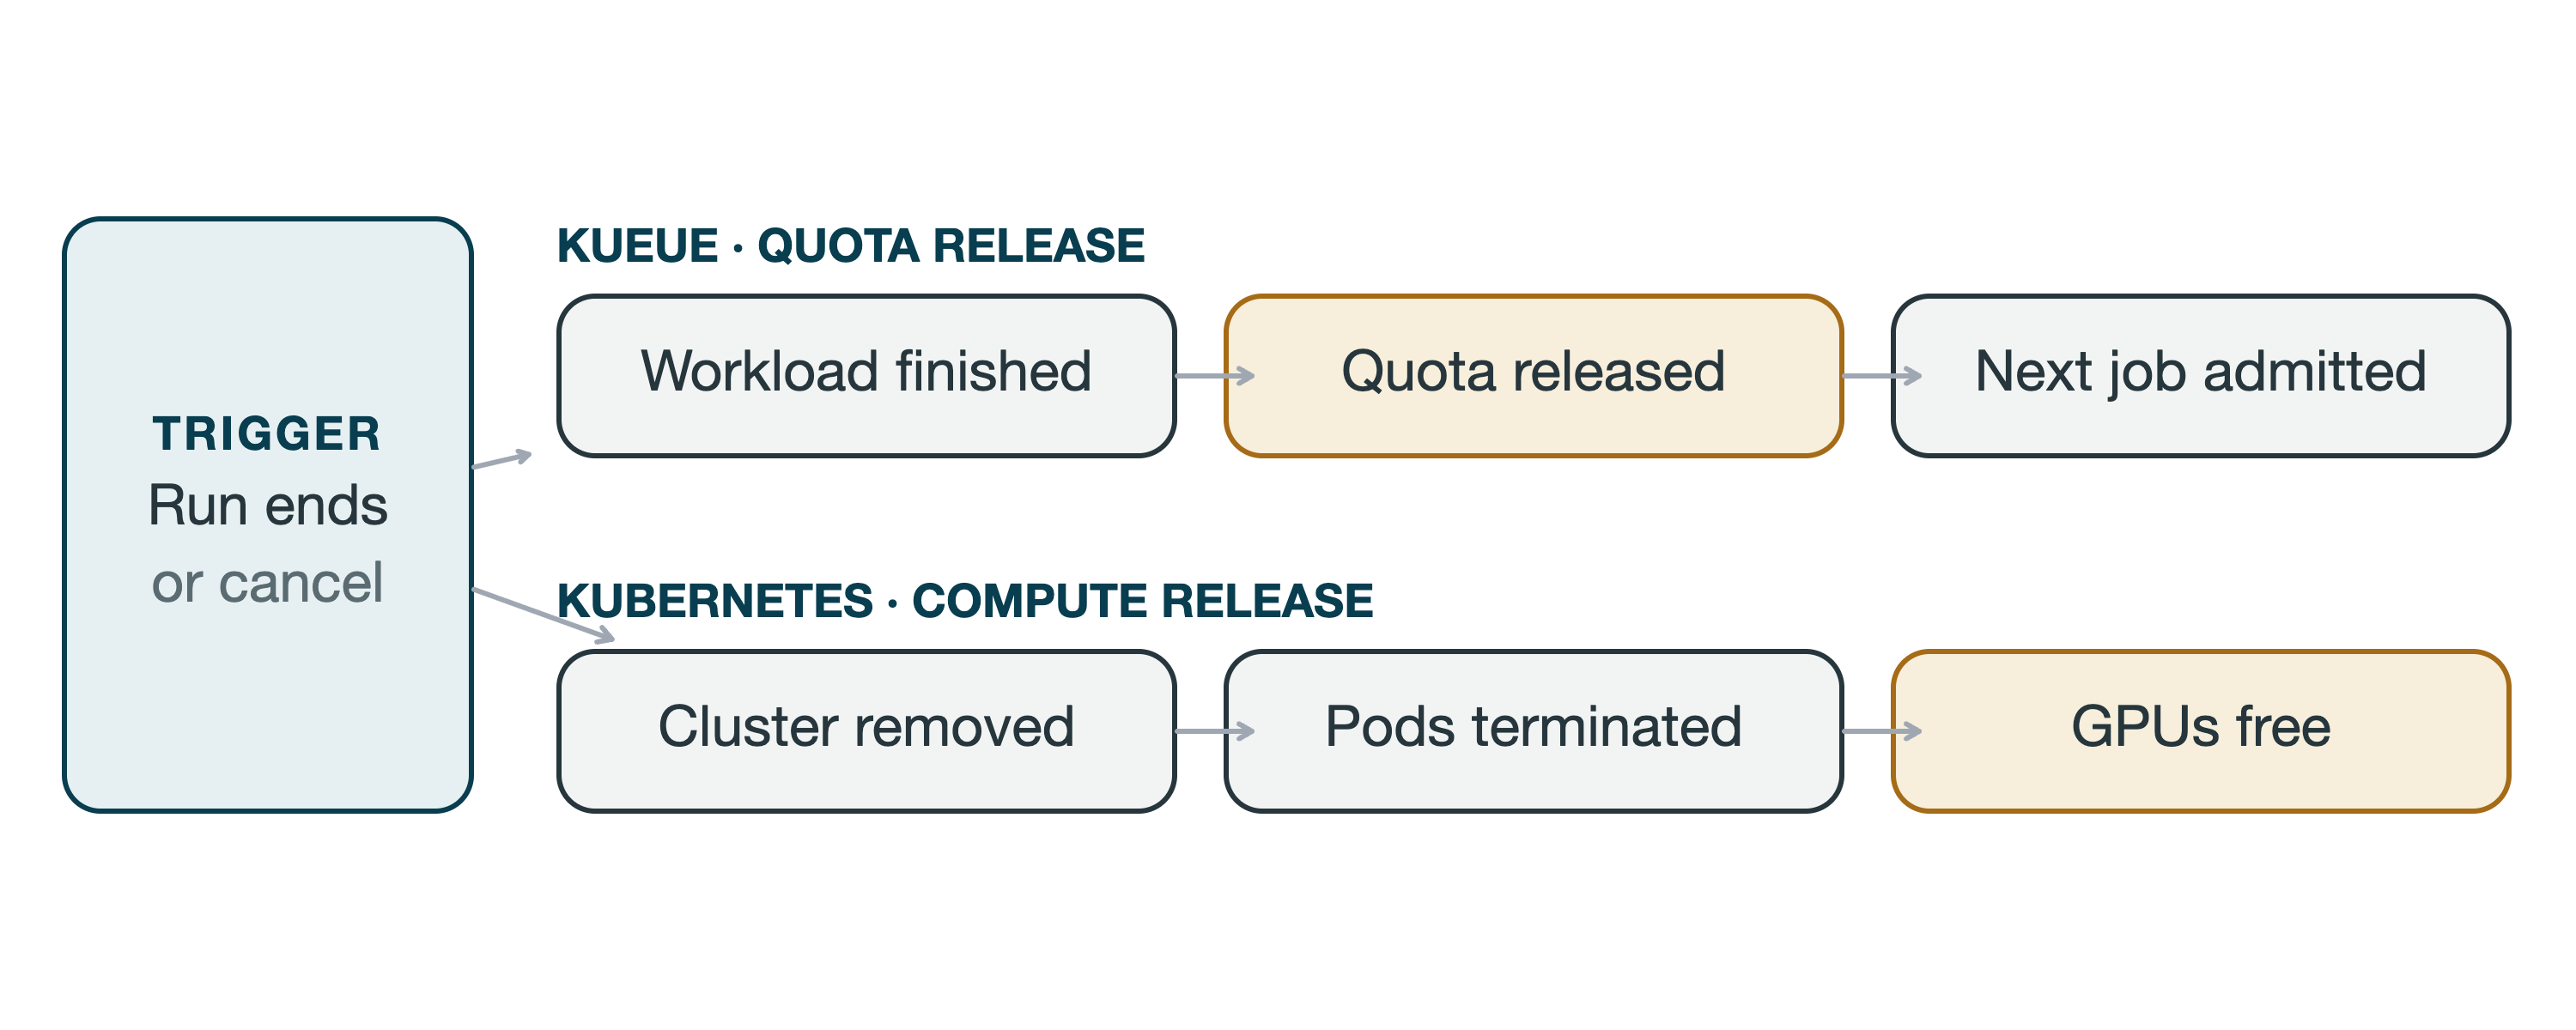
一条是 Kueue 的配额释放,Workload 结束后配额标记为 released,下一个任务可以准入。另一条是 Kubernetes 的 GPU 算力释放,KubeRay 删掉 RayCluster,Pod 终止,GPU 才真正空出来。两条线相互独立,只有都完成释放,后面排队的任务才能真正调度进来。
未来计划
TauGrid 刚刚开源,还有很多有待完善的地方。
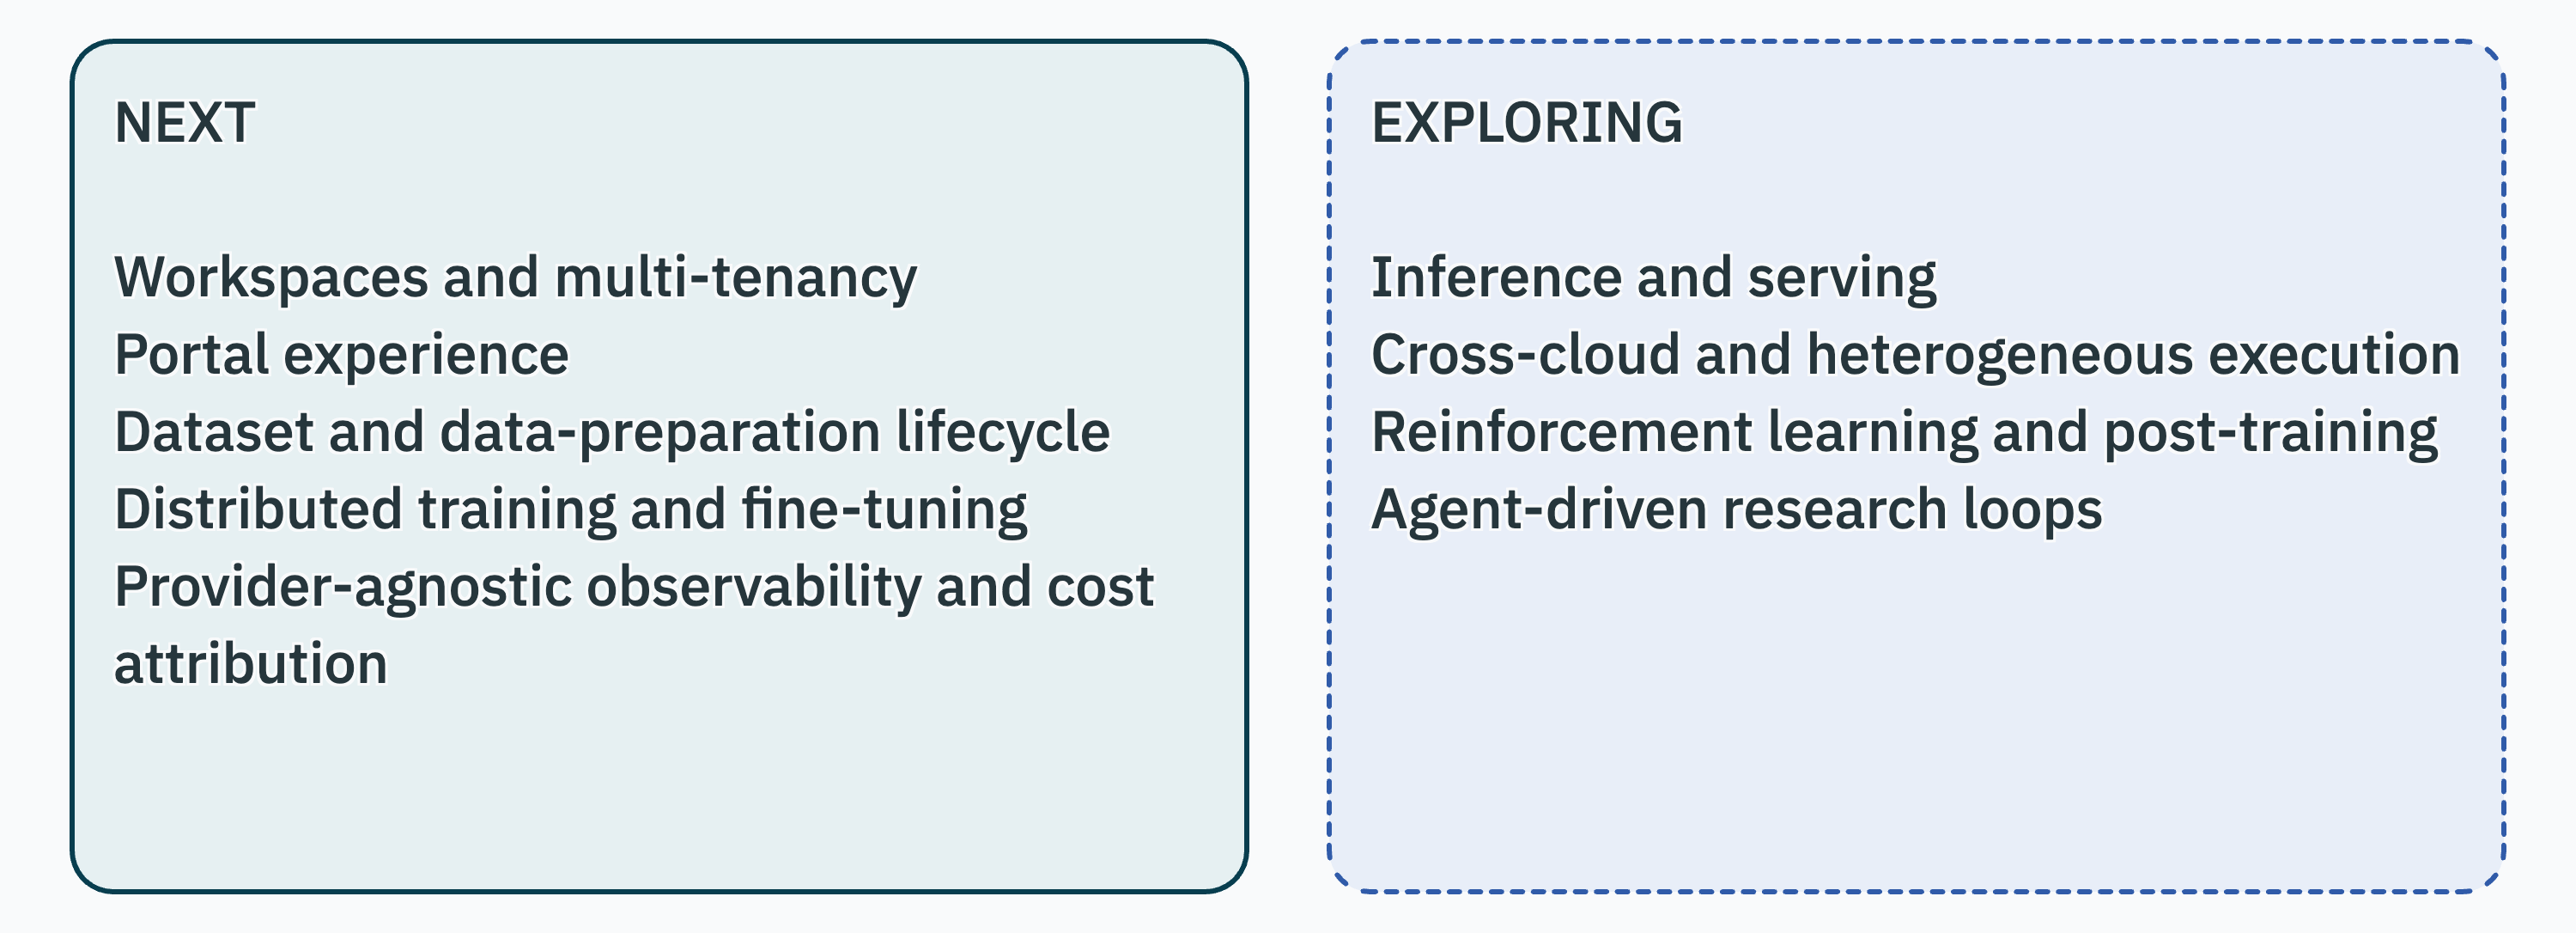
在下一版本中,我们将增强多租户支持、优化 Portal 体验、改进数据预处理,并完善分布式训练和 GPU 成本监控。
更远一点,我们还将进一步优化整套系统的性能、支持跨云 GPU 资源调度、改善强化学习和后训练的任务体验,并增加 Agent 驱动的自动研究等。
开源地址
TauGrid 完全开源,采用 MIT 协议。欢迎试用,更欢迎提 issue 告诉我们你在使用过程中发现的问题: