在 Kubernetes 上搭过 AI 训练平台的人应该都有这个感觉:配额排队要装 Kueue,分布式训练要装 KubeRay,GPU 健康检测要装 Node Problem Detector 和 DCGM,监控又是 Prometheus 一整套。一个一个装起来倒也不难,难的是怎么把这些东西攒成一套有机整合的统一平台。中间还得自己写一堆胶水:提交脚本、队列封装、健康检查、结果拉取,每样都得自己写,各种异常也得小心处理。
这让只想跑个训练任务的研究员不只需要学习 Kubernetes,还得去学习一大堆的生态项目,否则出了问题都不知道从哪儿查起。
我们做 TauGrid 就是为了把这些不同组件收到一起,并把整个系统全部开源了。我们把这几样核心组件收进了一套 Kubernetes 原生栈:tau CLI、Kueue 队列、KubeRay 编排、GPU 健康监控和可观测性,再到为平台和研究员提供不同视图的 Web Portal。从数据准备、模型训练一路到推理服务,支持整套 AI Stack 的统一管理。
以前这些组件得一个个搭,组件之间的集成也得自己维护。现在一个 tau 命令全部搞定。平台团队有一个统一的入口,研究员只要一个 CLI 就够了:提交任务、看进度、从失败恢复、拉回结果,全不再需要去碰 Kubernetes 和各种内部组件。
今天的文章,我就带你一起来看看 TauGrid 到底是什么。
TauGrid 是什么
说白了,TauGrid 就是把托管 AI 平台该有的东西搬到你自己的集群上。任务提交、分布式计算、GPU 共享、实验追踪、运维管控,全部通过同一个平台搞定。并且 TauGrid 是开源的,你可以自托管,部署到你自己管理的云或者数据中心里。
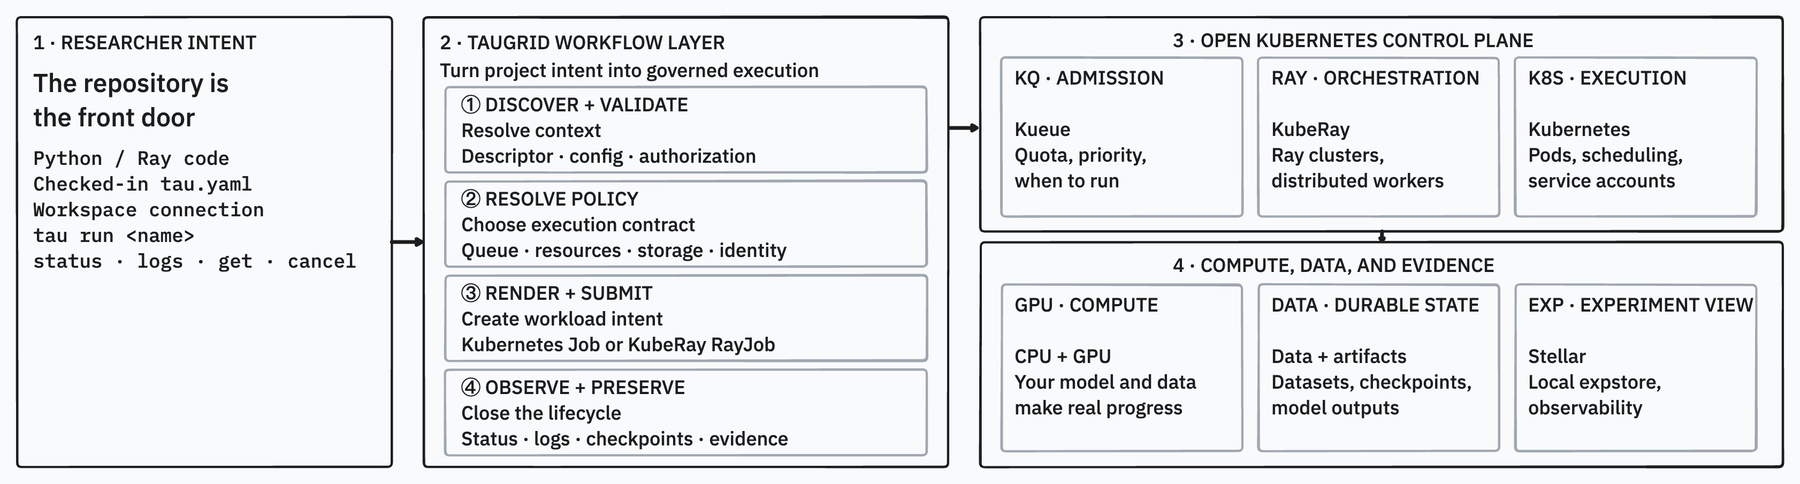
TauGrid 让研究员和平台团队可以各管各的。研究员从代码仓库和 Tau CLI 出发,平台团队负责配好工作区、队列、GPU 配置、存储、身份和可观测性。TauGrid 把所有底层组件和配置串起来,训练、微调、批量推理、模型服务都能覆盖。
有了 TauGrid 之后,平台团队可以少维护开头提到的多套系统,研究员上手也容易得多。
工作原理
你只要写一个 tau.yaml,就能把工作负载描述清楚。下面这个例子是在单张 A100 上跑 PyTorch 训练:
schema_version: 1
name: aks-gpu-quickstart

run:
  entrypoint: train.py
  workload_kind: rayjob

compute:
  gpus: 1
  workers: 1
  cpus: 16
  memory: 64Gi

runtime:
  image: mcr.microsoft.com/aks/ai-runtime/ray:py3.12-ray2.56.0-cuda13.0
  pip:
    - torch>=2.4.0
有了配置之后,执行 tau run 提交任务,它会先解析平台策略,渲染成 KubeRay 的 RayJob,再交给 Kueue 排队。整个过程里,TauGrid 会一直帮你盯着状态、日志、checkpoint 和 evidence。evidence record 把元数据、配置、日志、指标、checkpoint、执行历史全保存到持久化存储中。后续的复现、排查、审计,也都有充分的数据依据。
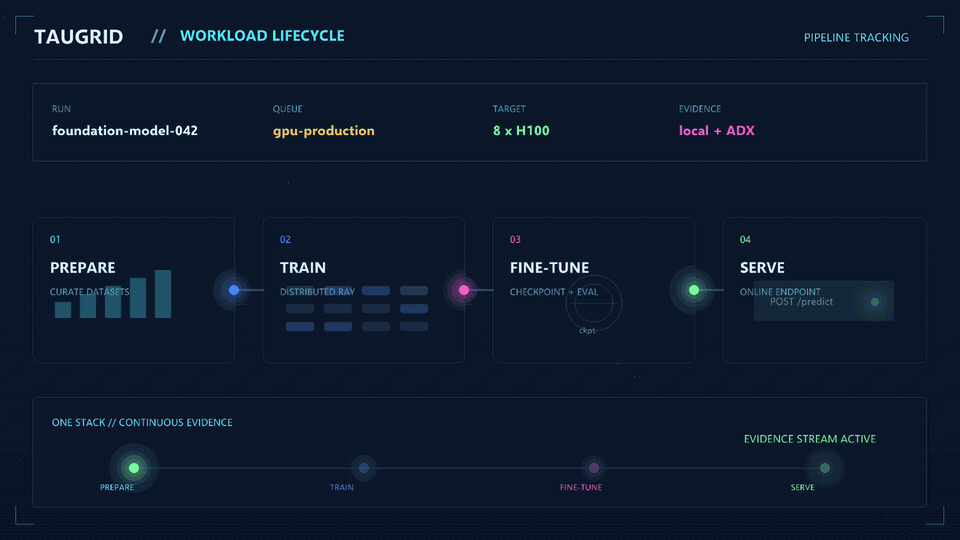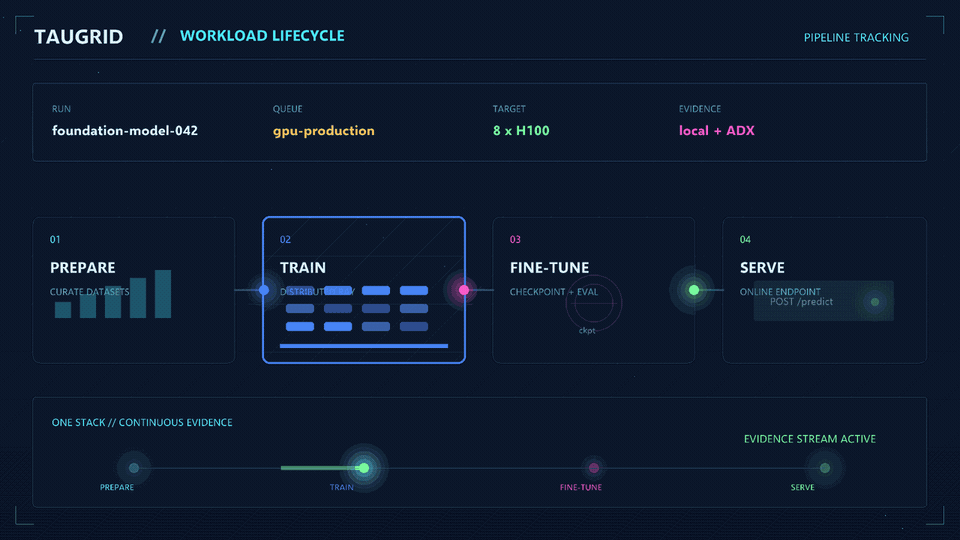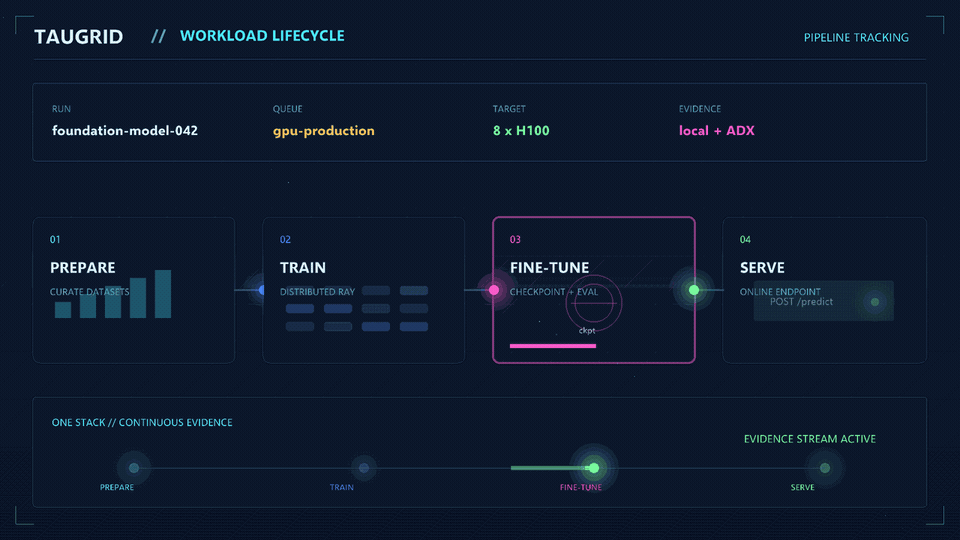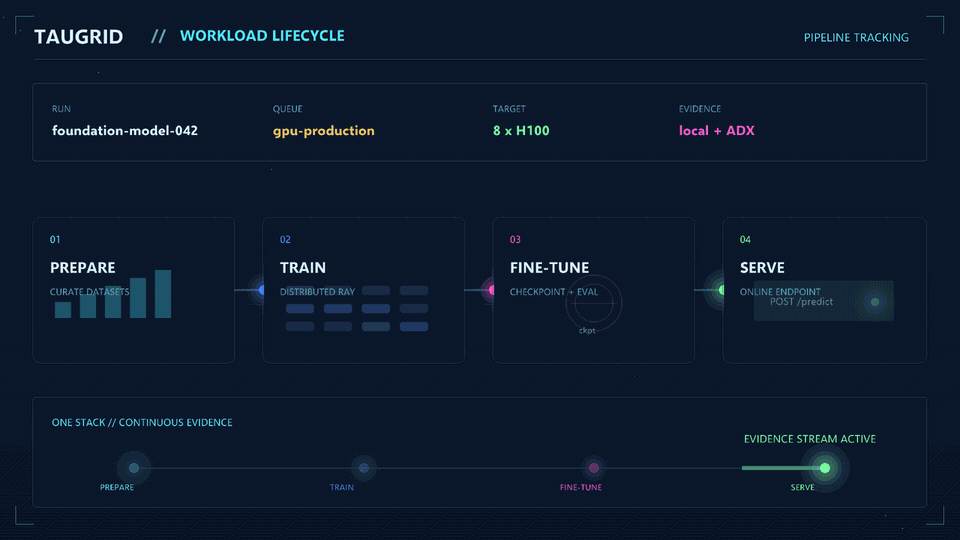
这一整套覆盖了 GPU 工作负载从头到尾的生命周期。下面这个动画是一个工作负载从数据准备到分布式训练、微调,再到推理端点就绪的全过程,整个过程就一份记录:
每个阶段 TauGrid 具体做什么,一张表说清楚:
| 阶段 | TauGrid 做的事 |
|---|---|
| 提交 | 校验配置,渲染成 Kubernetes Job 或 KubeRay RayJob |
| 排队 | 通过 Kueue 管理配额准入和优先级 |
| 执行 | 在 Kubernetes 上启动和管理分布式 Ray 工作负载 |
| 监控 | 全程跟踪状态、日志和 GPU 健康指标 |
| 恢复 | 支持重试、从 checkpoint 恢复和故障诊断 |
| Evidence | 保留工作负载历史、指标和产物,保证可复现 |
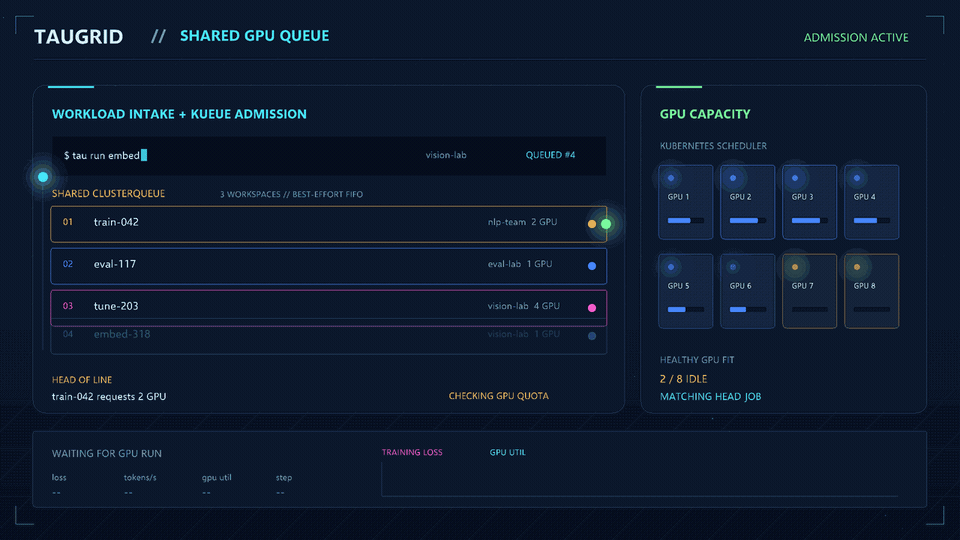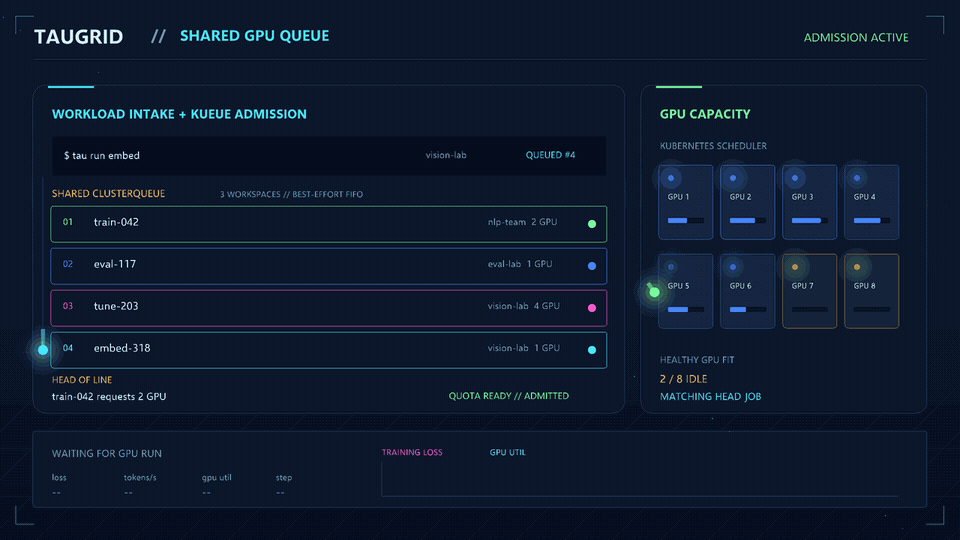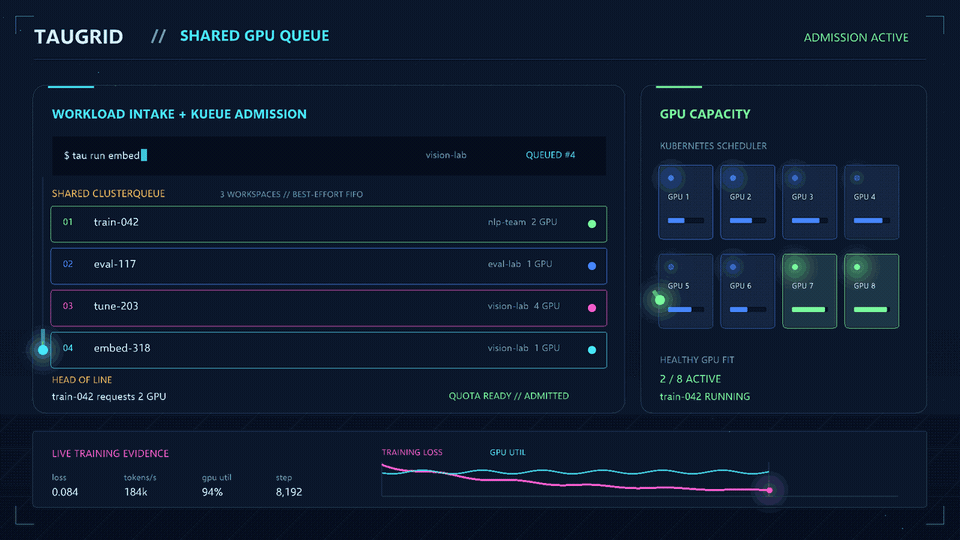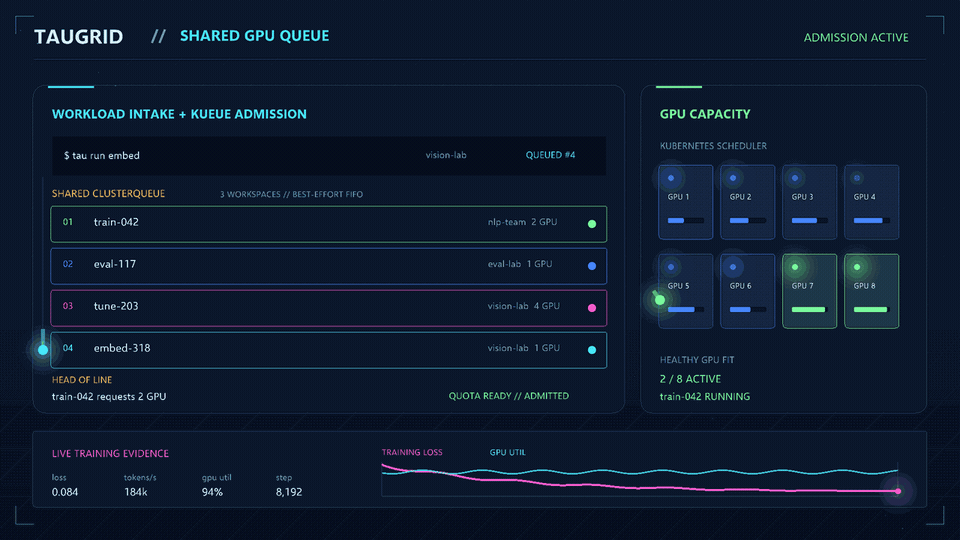
多个团队共用一个集群的时候,各自的工作负载进同一个 Kueue ClusterQueue。Kueue 按配额和优先级决定谁先运行,Kubernetes 再把任务放到健康的 GPU 上。
有一点需要说明的是:TauGrid 会一直聚焦在 AI 训练工作流和工作负载生命周期这一层。集群创建、Pod 调度、配额管控这些 Kubernetes 和 Kueue 已经做好的事,还有框架内部实现和模型代码,都还是使用大家熟悉的开源生态项目来实现。
快速上手
你需要一个 Kubernetes 1.30 以上的集群,外加 kubectl、Helm 3 和 Git。先装 Tau CLI:
curl -fsSL https://github.com/Azure/taugrid/releases/latest/download/install.sh | sh
export PATH="$HOME/.local/bin:$PATH"
tau version --short
把 TauGrid 装到集群上:
tau cluster install
tau cluster validate installation
建一个工作区,等它 Ready:
tau workspace create "taugrid-default" --apply

kubectl wait \
  --for=jsonpath='{.status.phase}'=Ready \
  workspaces.tau.azure.com/taugrid-default \
  --namespace tau-system \
  --timeout=5m
跑第一个工作负载:
git clone https://github.com/Azure/taugrid.git
cd taugrid
tau run --config examples/cpu-multi-interest-ray/tau.yaml
tau run status cpu-multi-interest-ray --watch
tau run logs cpu-multi-interest-ray -f
这个例子跑的是 CPU 任务,不需要 GPU 节点。集群准备、工作区配置、GPU 任务、交接给研究员这一整套分步指南,都在 Getting Started on Kubernetes 里。
仓库里还有几个可以直接跑的例子:
| 示例 | 演示内容 |
|---|---|
| CPU 队列 | Kueue 准入、pending 状态和团队间借用,不需要 GPU |
| GPU Ray Tune | 单 GPU 上的超参搜索,带确定性验证 |
| 实验 evidence | 持久化指标、Stellar 可视化和 evidence 验证 |
| 完整集群 | Terraform 创建的 AKS 集群,带 GPU 节点,端到端验证 |
更多示例和详细演练都在仓库的 examples 里。
后续规划
TauGrid 现在还在快速迭代,完整的 roadmap 都放在仓库里。大方向有这么几个。
多租户这块,后续会支持多个工作区,按工作区隔离的身份、权限和配额,再加一个交互式门户,可以直接在上面提交和管理工作负载。分布式训练这块,会补上 PyTorch DDP、FSDP、DeepSpeed 和 Hugging Face LoRA/QLoRA 的端到端示例,再加上完整的数据集生命周期:获取、暂存、校验、分词、注册。
推理方面,vLLM、SGLang、TensorRT-LLM 的服务示例都会补上。多集群和多云这块,支持跨云执行工作负载,数据、checkpoint 和产物可移植,再加上不锁定云厂商的可观测性和成本归因。
下一步
TauGrid 刚开源,要做的事还很多。我们想在开放环境下把它做好,你的反馈对我们很重要。欢迎安装尝试,遇到任何问题都可以提 issue,更欢迎提 PR 一起增强完善这个项目,觉得哪里设计得不对也请告诉我。
相关链接: